Instalação
Requisitos
Magento 2.4.x — testado em 2.4.9, compatível com versões 2.4.* anteriores. PHP 8.1–8.5. Funciona tanto com o tema predefinido Luma como com o tema Hyvä — o módulo corre inteiramente no admin e escreve atributos de catálogo padrão, pelo que o seu storefront mostra o conteúdo melhorado sem alterações aos templates. Depende do módulo gratuito codingrow/module-core, instalado automaticamente. Requer uma chave API de pelo menos um provedor de IA para o passo de melhoria/reescrita (Anthropic, OpenAI, Google ou OpenRouter) e, para a tradução, uma chave de tradução automática (DeepL) ou um LLM usado como tradutor. Todo o uso de IA e tradução é-lhe faturado diretamente pelo provedor — Codingrow nunca aplica margem.
Passos de instalação
- Adicione as credenciais que receberá por email ao ficheiro
auth.jsonna raiz do seu projeto Magento:{ "http-basic": { "repo.codingrow.com": { "username": "...", "password": "..." } } } composer config repositories.codingrow composer https://repo.codingrow.comcomposer require codingrow/module-ai-babel-enchanterbin/magento module:enable Codingrow_BabelEnchanterbin/magento setup:upgrade && bin/magento setup:di:compile && bin/magento cache:flush(setup:di:compileé necessário num deploy de produção; pode ignorá-lo num ambiente de desenvolvimento)- Cole a sua chave de licença em Admin → Stores → Configuration → Codingrow → AI Babel Enchanter → License → License Key, guarde e depois limpe a cache.
Configuração
Stores → Configuration → Codingrow → AI Babel Enchanter.
| Definição | O que faz | Predefinição | Notas |
|---|---|---|---|
| License Key | A chave de licença emitida para este domínio. | — | Aceita uma chave de módulo único ou uma chave de subscrição Codingrow. Sem uma licença válida o módulo não funciona. |
| Enable | Interruptor principal do módulo. | No | Requer uma licença válida e pelo menos uma chave API de um provedor. |
| Enhancement provider | Provedor, modelo e chave API que reescrevem e melhoram o texto (o motor de melhoria/reescrita). | — | Use Load models junto ao campo Model em vez de digitar um id. |
| Translation provider | Como são produzidos os idiomas de destino: um serviço de tradução automática (DeepL) ou um LLM usado como tradutor, com o seu modelo e a sua chave. | — | Traduza com o mesmo LLM do passo de melhoria, ou com uma chave MT dedicada para um custo por caractere mais baixo. |
| SEO options | Interruptores para o que é gerado: meta title, meta description, meta keywords, URL key. | — | Desative tudo o que não quiser que o módulo toque. |
| Resilience | Circuit breaker: nova tentativa automática em falhas transitórias, horas de cooldown antes de repetir, pausa após N erros consecutivos. | — | Protege uma execução longa quando o provedor fica sem crédito ou aplica rate limit. |
Desinstalação
Coloque Enable em No e guarde para parar imediatamente todo o processamento — o conteúdo do seu catálogo permanece exatamente como está. Se quiser primeiro voltar ao texto original, execute um rollback (consulte o Guia do utilizador). Para remover o módulo por completo: bin/magento module:disable Codingrow_BabelEnchanter depois composer remove codingrow/module-ai-babel-enchanter.
Provedores & custo
Escolher provedores
AI Babel Enchanter tem dois slots de provedor independentes: um para o passo de melhoria/reescrita (um LLM) e outro para a tradução (um LLM ou um serviço dedicado de tradução automática como o DeepL). Traz as suas chaves e todo o uso é-lhe faturado diretamente pelo provedor que escolher — Codingrow nunca aplica margem. Escolha o modelo de melhoria pela qualidade e traduza com o mesmo LLM ou com uma chave MT mais barata por caractere.
Anthropic (modelos Claude)
- Inicie sessão em console.anthropic.com.
- Vá a console.anthropic.com/settings/keys.
- Clique em Create Key, dê-lhe um nome (ex. "AI Babel Enchanter") e copie o valor.
- Cole-o no slot de provedor com Provider definido como Anthropic e depois use Load models.
OpenAI (modelos GPT)
- Inicie sessão em platform.openai.com.
- Vá a platform.openai.com/api-keys.
- Clique em Create new secret key, dê-lhe um nome e copie-a imediatamente — é mostrada apenas uma vez.
- Cole-a no slot de provedor com Provider definido como OpenAI e depois use Load models.
Google (modelos Gemini)
- Inicie sessão em aistudio.google.com com uma conta Google.
- Vá a aistudio.google.com/app/apikey.
- Clique em Create API key, escolha ou crie um projeto Google Cloud e copie a chave.
- Cole-a no slot de provedor com Provider definido como Google e depois use Load models.
OpenRouter (uma chave, os modelos de muitos provedores)
- Inicie sessão em openrouter.ai.
- Vá a openrouter.ai/keys.
- Clique em Create Key, dê-lhe um nome e copie o valor.
- Cole-o no slot de provedor com Provider definido como OpenRouter e depois use Load models.
DeepL (tradução automática)
- Inicie sessão em deepl.com/pro-api.
- Abra Account → API keys e copie a sua Authentication Key.
- Cole-a no slot Translation provider com o tradutor definido como DeepL.
O DeepL é cobrado por caractere (cerca de €20 por 1M de caracteres), normalmente mais barato do que um LLM para tradução simples. Também pode ignorar o DeepL por completo e traduzir com o mesmo LLM do passo de melhoria.
Load models — sem id de modelo para digitar
Depois de inserida a chave API, guarde a secção e clique em Load models por baixo do campo Model: o módulo chama o endpoint de lista de modelos do provedor com a sua chave e preenche uma lista pendente com todos os modelos que a sua chave pode realmente usar — escolha da lista em vez de digitar um id. Mantém-se um campo de texto manual como recurso para um id de modelo ainda não presente na lista. Uma ligação logo abaixo do campo aponta sempre para a página de chaves correta do provedor atualmente selecionado.
Estimar o custo de uma execução sobre todo o catálogo
Uma passagem completa tem dois fatores de custo que se somam por produto: melhoria (tokens LLM, com preço por milhão) e tradução (caracteres, com preço por milhão, multiplicados pelo número de idiomas de destino). Use a calculadora abaixo para dimensionar uma execução antes de a lançar — é uma estimativa puramente indicativa; os seus números reais dependem do comprimento do conteúdo e dos modelos que escolher.
Full-catalog run cost calculator
Estimate what one full pass over your catalog costs. Two cost drivers add up per product: improve (LLM tokens, priced per million) and translate (characters, priced per million, multiplied by the number of target languages). Everything is billed to you directly by the AI/translation provider — this is a purely indicative estimate.
| Improve model | ~ improve / product | Full-catalog improve ~ |
|---|---|---|
| Gemini 2.x Flash | ~€0.0004 | ~€2 |
| OpenAI gpt-4o-mini | ~€0.0006 | ~€3 |
| Claude Haiku 4.5 | ~€0.004 | ~€20 |
| Claude Sonnet 4.5 | ~€0.015 | ~€75 |
Guia do utilizador
Perfis e persona prompt
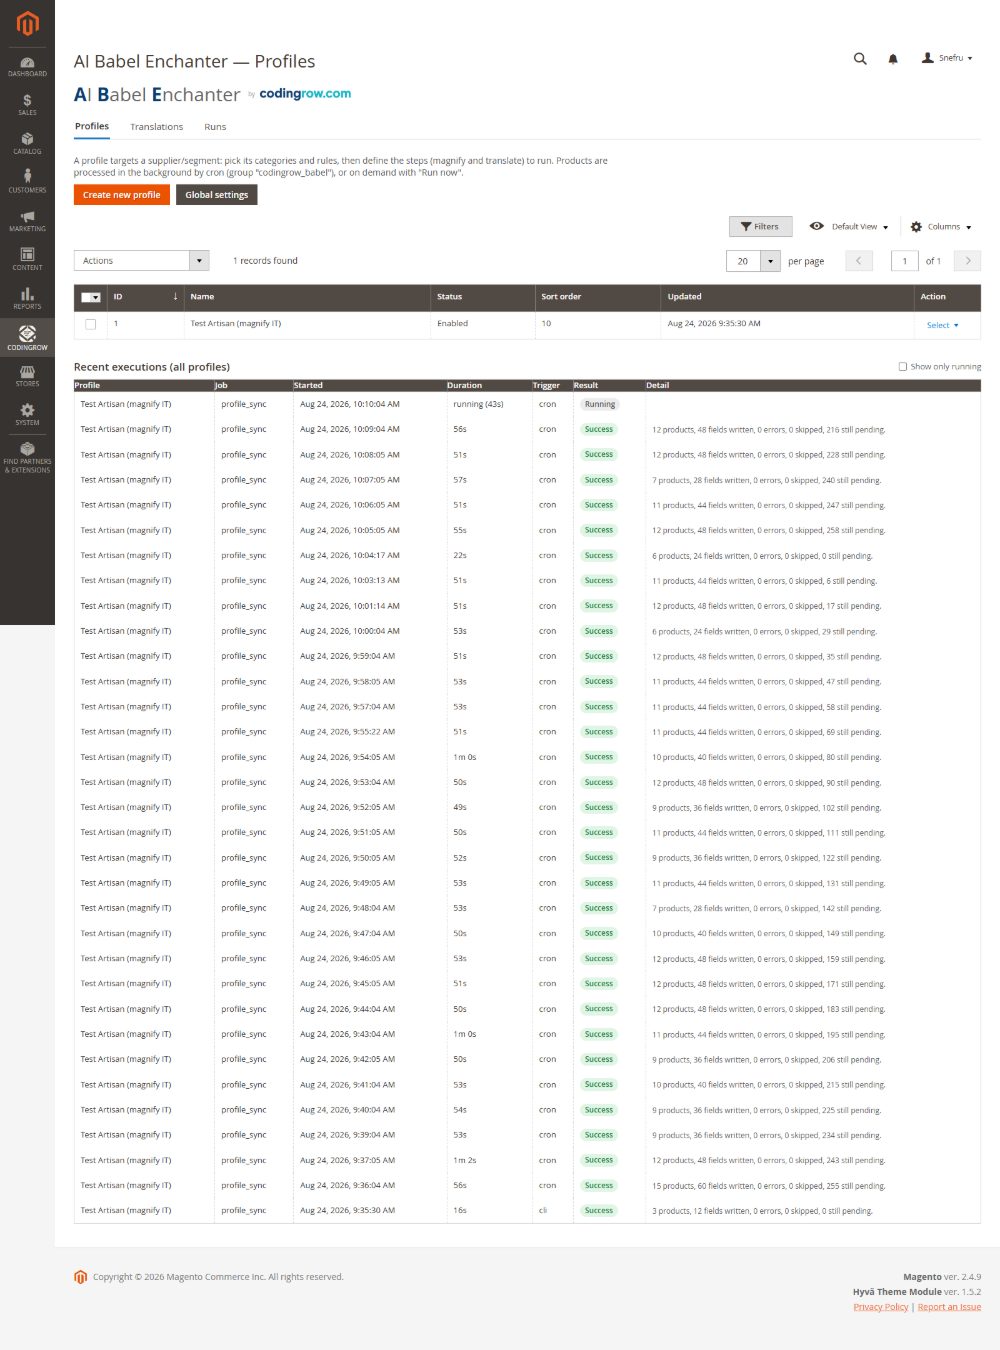
Tudo o que o módulo faz está organizado em perfis. Um perfil é uma configuração reutilizável que executa sobre uma parte do catálogo: que atributos pode tocar, a pipeline de passos a aplicar, uma eventual categoria exclusiva para que o perfil só opere sobre produtos dessa categoria, e um persona prompt — instruções em texto livre que definem o tom de voz e as regras da reescrita. Os perfis são anti-revert: um produto já processado por um perfil é ignorado na execução seguinte a menos que o reinicie, por isso reexecutar é seguro.
Grupos e passos (a pipeline)
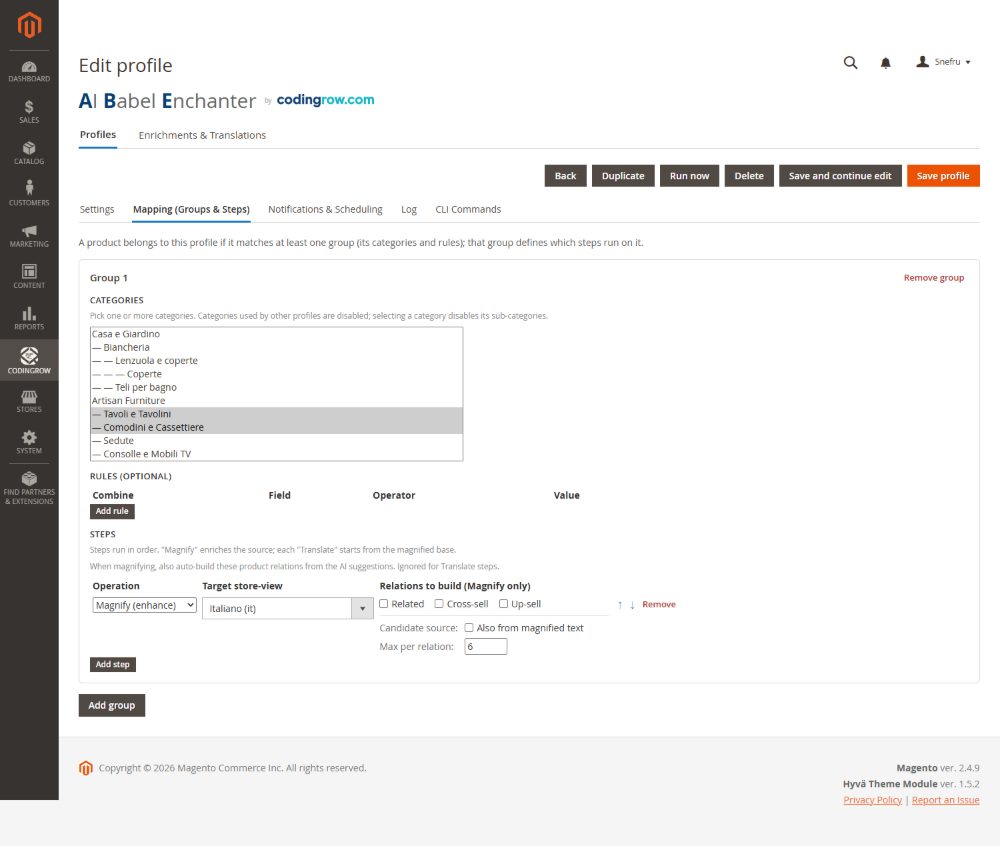
Dentro de um perfil define grupos de passos que correm por ordem. Os dois tipos de passo principais são improve (reescrever/enriquecer o texto de origem com o provedor de melhoria) e translate (produzir as versões no idioma de destino). A pipeline normal é improve → translate: o idioma de origem é reescrito primeiro, depois é o texto melhorado que é traduzido, de modo que cada store view herda o melhor conteúdo em vez de traduzir o texto antigo. Agrupar permite aplicar passos diferentes a atributos diferentes e executá-los como uma única operação.
AI — Models (o pool de credenciais)
Registe cada IA uma só vez no separador AI — Models e reutilize-a em todo o lado. Cada linha é uma credencial: um nome personalizado, o provedor (Anthropic, OpenAI, Google/Gemini, OpenRouter ou DeepL), a chave API (armazenada cifrada), o modelo — digite-o ou clique em Load models para escolher apenas os modelos que a sua chave pode realmente usar, cada um anotado com a sua velocidade de resposta — uma capacidade (translate / enhancement / both), uma predefinição, uma ordem de fallback e um indicador de ativação.
Adicione quantas quiser: se uma chave se esgotar (sem crédito, em rate limit, um erro de autenticação), o módulo marca-a em cooldown e passa para a credencial seguinte na cadeia, entre provedores, para que uma execução longa sobreviva a uma chave morta. O modelo e o prompt são depois escolhidos por passo no perfil — enriqueça com um modelo de topo e traduza os títulos de baixo valor com um barato e rápido, numa única pipeline.
Max tokens (por credencial) é o limite dos tokens que um modelo pode gerar — um limite, não um objetivo, por isso paga apenas o que é produzido. Demasiado baixo e o texto fica cortado; com modelos de raciocínio pode até não devolver nada. A predefinição de 4000 cobre descrição + descrição curta + título + meta. Extended thinking está desativado por predefinição (não melhora os textos de venda) e pode definir um preço opcional por IA para alimentar a estimativa de custo.
AI Compare
Abra o separador AI Compare de um perfil, marque os modelos a comparar e escolha alguns produtos de amostra. Run comparison enriquece cada amostra com cada modelo (um dry-run — nada é escrito) numa matriz: uma coluna por modelo, uma linha por produto, cada célula mostra o título gerado com uma referência, o tempo de geração, um custo € indicativo (a partir das contagens reais de tokens da API) e um Preview que abre o resultado totalmente renderizado.
Um juiz — o modelo que escolhe no menu pendente, idealmente o mais capaz — avalia cada saída quanto a qualidade linguística, formatação, medidas contextualizadas, registo premium, validade do JSON e SEO, e escolhe um vencedor; o veredicto acrescenta o tempo médio e o custo médio por modelo. Escolha All models judge e cada modelo devolve o seu próprio veredicto, uma tabela cada. Um temporizador ao vivo e um skeleton mostram o juiz a trabalhar, um botão Stop interrompe, e a última comparação é guardada no perfil para que reapareça — com um carimbo de data/hora — sem reexecutar.
Como funcionam os tokens (e o que causa configurá-los mal)
Cada passo de magnify ou translate é uma chamada a um modelo de IA. O modelo lê o seu prompt de persona, os campos de origem do produto e — quando também gera o título — uma pequena amostra de títulos afins: isso é o input. Depois escreve um único objeto JSON com os campos reescritos: isso é o output. O provedor cobra-lhe ambos, mas os tokens de saída custam várias vezes mais do que os de entrada, por isso é o comprimento do texto gerado que determina o custo.
Max tokens limita apenas o output que um modelo pode produzir numa chamada. É um limite, não um alvo: se o texto terminar naturalmente antes paga só pelo que foi escrito, por isso um limite generoso nunca custa mais — apenas evita que um bom output seja cortado. O valor predefinido de 4000 cobre com folga uma descrição rica mais short description, título e meta description juntos.
O que causa um limite demasiado baixo. Se o output fosse mais longo do que o limite, a resposta é truncada a meio da frase e o JSON nunca fecha — o módulo não consegue interpretá-lo. Alguns modelos recentes também fazem um raciocínio oculto antes de escrever: com um limite apertado podem gastar todo o orçamento a pensar e devolver absolutamente nada. Em qualquer dos casos, o Babel não mantém silenciosamente o texto original — marca esse produto como falhado com o motivo real na fila, para que possa aumentar o limite e tentar de novo. Se os produtos voltarem invulgarmente curtos ou “presos na língua de origem”, o limite de tokens é a primeira coisa a verificar.
Extended thinking está desativado por predefinição, de propósito. Para os textos de venda do catálogo não melhora o resultado — sai o mesmo texto — enquanto consome tokens e tempo e arrisca a armadilha da resposta vazia acima. Deixe-o desativado para a geração; o juiz do AI Compare ativa-o apenas onde o raciocínio ajuda mesmo, e recorre com elegância a uma alternativa quando o modelo escolhido não o suporta.
Na prática: mantenha Max tokens em 4000 (ou um pouco mais para descrições muito longas), fique atento à fila em busca de falhas com um motivo claro em vez de um output errado silencioso, e deixe a estimativa de custo — alimentada pelas contagens reais de tokens que a API devolve — dizer-lhe quanto cada execução vai realmente custar antes de a lançar.
As características objetivas do produto
Em muitos catálogos as medidas não estão em nenhum atributo: estão dentro do nome. Rolo de Papel de Parede 10 m, Extensão Elétrica 5 m. Uma pessoa lê isso sem esforço, a loja não: quem pede dez metros recebe uma ficha de uma peça, porque nenhum campo diz quanto mede uma peça.
Enquanto trabalha um artigo, o Babel anota os seus dados mensuráveis no atributo Product characteristics (Babel) da ficha do produto, que você lê e corrige.
unita_vendita: confezione
copertura_pezzo: 2.22 m2
pezzi_confezione: 8
spessore: 8 mm
materiale: laminado
tipologia: piso flutuante (dedotto)
unita_vendita nunca é deduzida. É um termo comercial: diz a que se refere o preço. Uma linha diferente de pezzo só é escrita se as três condições se verificarem — não é deduzida, existe o número que torna a conta possível (pezzi_confezione para a embalagem, copertura_pezzo para os metros) e a prova está nos dados do produto, verificada pelo módulo e não aceite por palavra da IA. Se nada o disser, a linha simplesmente não existe, e isso significa que o preço é da peça: o lado seguro.
A conta é feita por copertura_pezzo — quanto cobre UMA peça — que é uma medida e se obtém do produto. Uma embalagem de laminado que cobre 2,22 m² leva unita_vendita: confezione e copertura_pezzo: 2.22 m2, e um pedido de trinta metros quadrados passa a catorze embalagens. Sem o par eram trinta embalagens: mais do dobro.
O marcador (dedotto) é a fronteira. Uma linha que acaba assim não foi escrita por ninguém: a IA deduziu-a. Serve para entender e procurar, mas dela nunca se tira uma quantidade. Para confirmar um dado apaga-se essa palavra; o que está errado corrige-se, o que não pertence tira-se. O catálogo é seu.
Num produto com variantes cada um leva a sua parte: o pai o que vale para todas (a unidade de venda, o material, o tipo), cada variante o que a distingue (a sua medida, o seu diâmetro). As variantes só são processadas quando o que muda é uma medida: se muda só a cor, a variante não teria nada de seu a dizer. Um agrupado ou um bundle não têm medidas próprias — são uma lista de artigos, cada um com as suas — e em virtuais e descarregáveis não se escreve nada: um curso não se mede.
Não reescreve os seus textos: é uma chamada à parte, pequena, com memória própria. Para os artigos já processados há o botão Anotar características na página do perfil, ou bin/magento babel:params --profile=3. Num catálogo real: 38 artigos pai e 116 variantes percorridos, a unidade de venda em 34 dos 38 pais — é do pai e nunca da variante, porque como uma coisa se vende não muda entre o 80 e o 100.
Numa variante o campo está muitas vezes vazio, e é o resultado certo: o que a distingue já está num atributo do Magento (o seu peso, a medida em que varia), e escrevê-lo também aqui faria duas cópias destinadas a divergir — com a variante a ganhar ao pai. Nesse catálogo 97 das 116 variantes levam uma linha própria, as outras 19 não tinham nada a acrescentar. E as regras valem também sobre o que já está escrito: uma linha deixada por uma versão anterior que viola o formato de hoje é retirada na passagem seguinte, enquanto uma linha que corrigiu à mão nunca é tocada.
Tipos de produto e tratamento diferenciado
Um produto configurável não é um artigo único, um agrupado não é um pacote, e um produto virtual ou descarregável não se envia. O módulo reconhece o tipo sozinho e entrega à IA uma descrição da estrutura, que muda o que o texto diz e o que não deve dizer.
Onde se liga. Separador Mapping do perfil, no passo concreto: Contexto de estrutura do produto. Desligado por omissão: ligá-lo muda o que a IA recebe e, por isso, regenera as fichas desse perfil na passagem seguinte. Ligue-o antes de uma passagem nova, não a meio de uma em curso.
- Configurável — recebe o eixo de escolha com a etiqueta na língua da loja (por exemplo medida: 80, 100), as opções e os atributos que realmente diferem entre os filhos, apurados comparando-os. Não há nada para configurar à mão: os atributos de um configurável o módulo deteta-os sozinho. Preços, preços especiais, custos e escalões ficam de fora de propósito, porque mudam e um texto que os cita envelhece mal. O texto resultante descreve a gama; um título nunca deve levar o valor de uma só opção (por exemplo Tubo 1m 100 quando 100 é uma das medidas).
- Pacote — recebe os títulos das opções, quais são obrigatórias e os artigos selecionáveis em cada uma, para que o texto possa explicar como o produto é composto.
- Agrupado — recebe a lista de artigos associados, para que o texto diga que se compram juntos e para que serve cada um.
- Virtual — recebe apenas o tipo, e basta: é proibido à IA mencionar envio, entrega, embalagem e peso. Sem essa regra o modelo escreve envio rápido mesmo para uma extensão de garantia.
- Descarregável — recebe o número de ficheiros e se existe uma amostra: o texto explica a entrega digital, e o envio continua proibido.
As variantes não são trabalhadas. Ao lado está Ignorar variantes, ligado por omissão ao nível do grupo: um produto que aparece como filho de um configurável fica fora da fila. Não tem uma página que o cliente possa abrir, por isso enriquecê-la é despesa sem retorno; num catálogo construído sobre variantes são a maior parte da fila. Quem vende as variantes como artigos próprios desliga-o.
Limitar os alvos. No mesmo passo, Tipos de produto e Visibilidade restringem a fila ao que quer mesmo trabalhar — por exemplo só os configuráveis, ou só os produtos visíveis em catálogo e pesquisa.
Cross-sell, relacionados e up-sell (relações com IA)
Três interruptores independentes permitem a um perfil propor produtos cross-sell, relacionados e up-sell usando a IA. O modelo sugere sempre e apenas SKU reais do seu catálogo — não pode inventar um produto inexistente — e as sugestões são escritas nas ligações nativas cross-sell/relacionados/up-sell do Magento, pelo que aparecem nos blocos padrão do storefront. Ative apenas os tipos de relação que quer que o módulo faça a gestão.
Pré-visualização em dry-run (e renderizada)
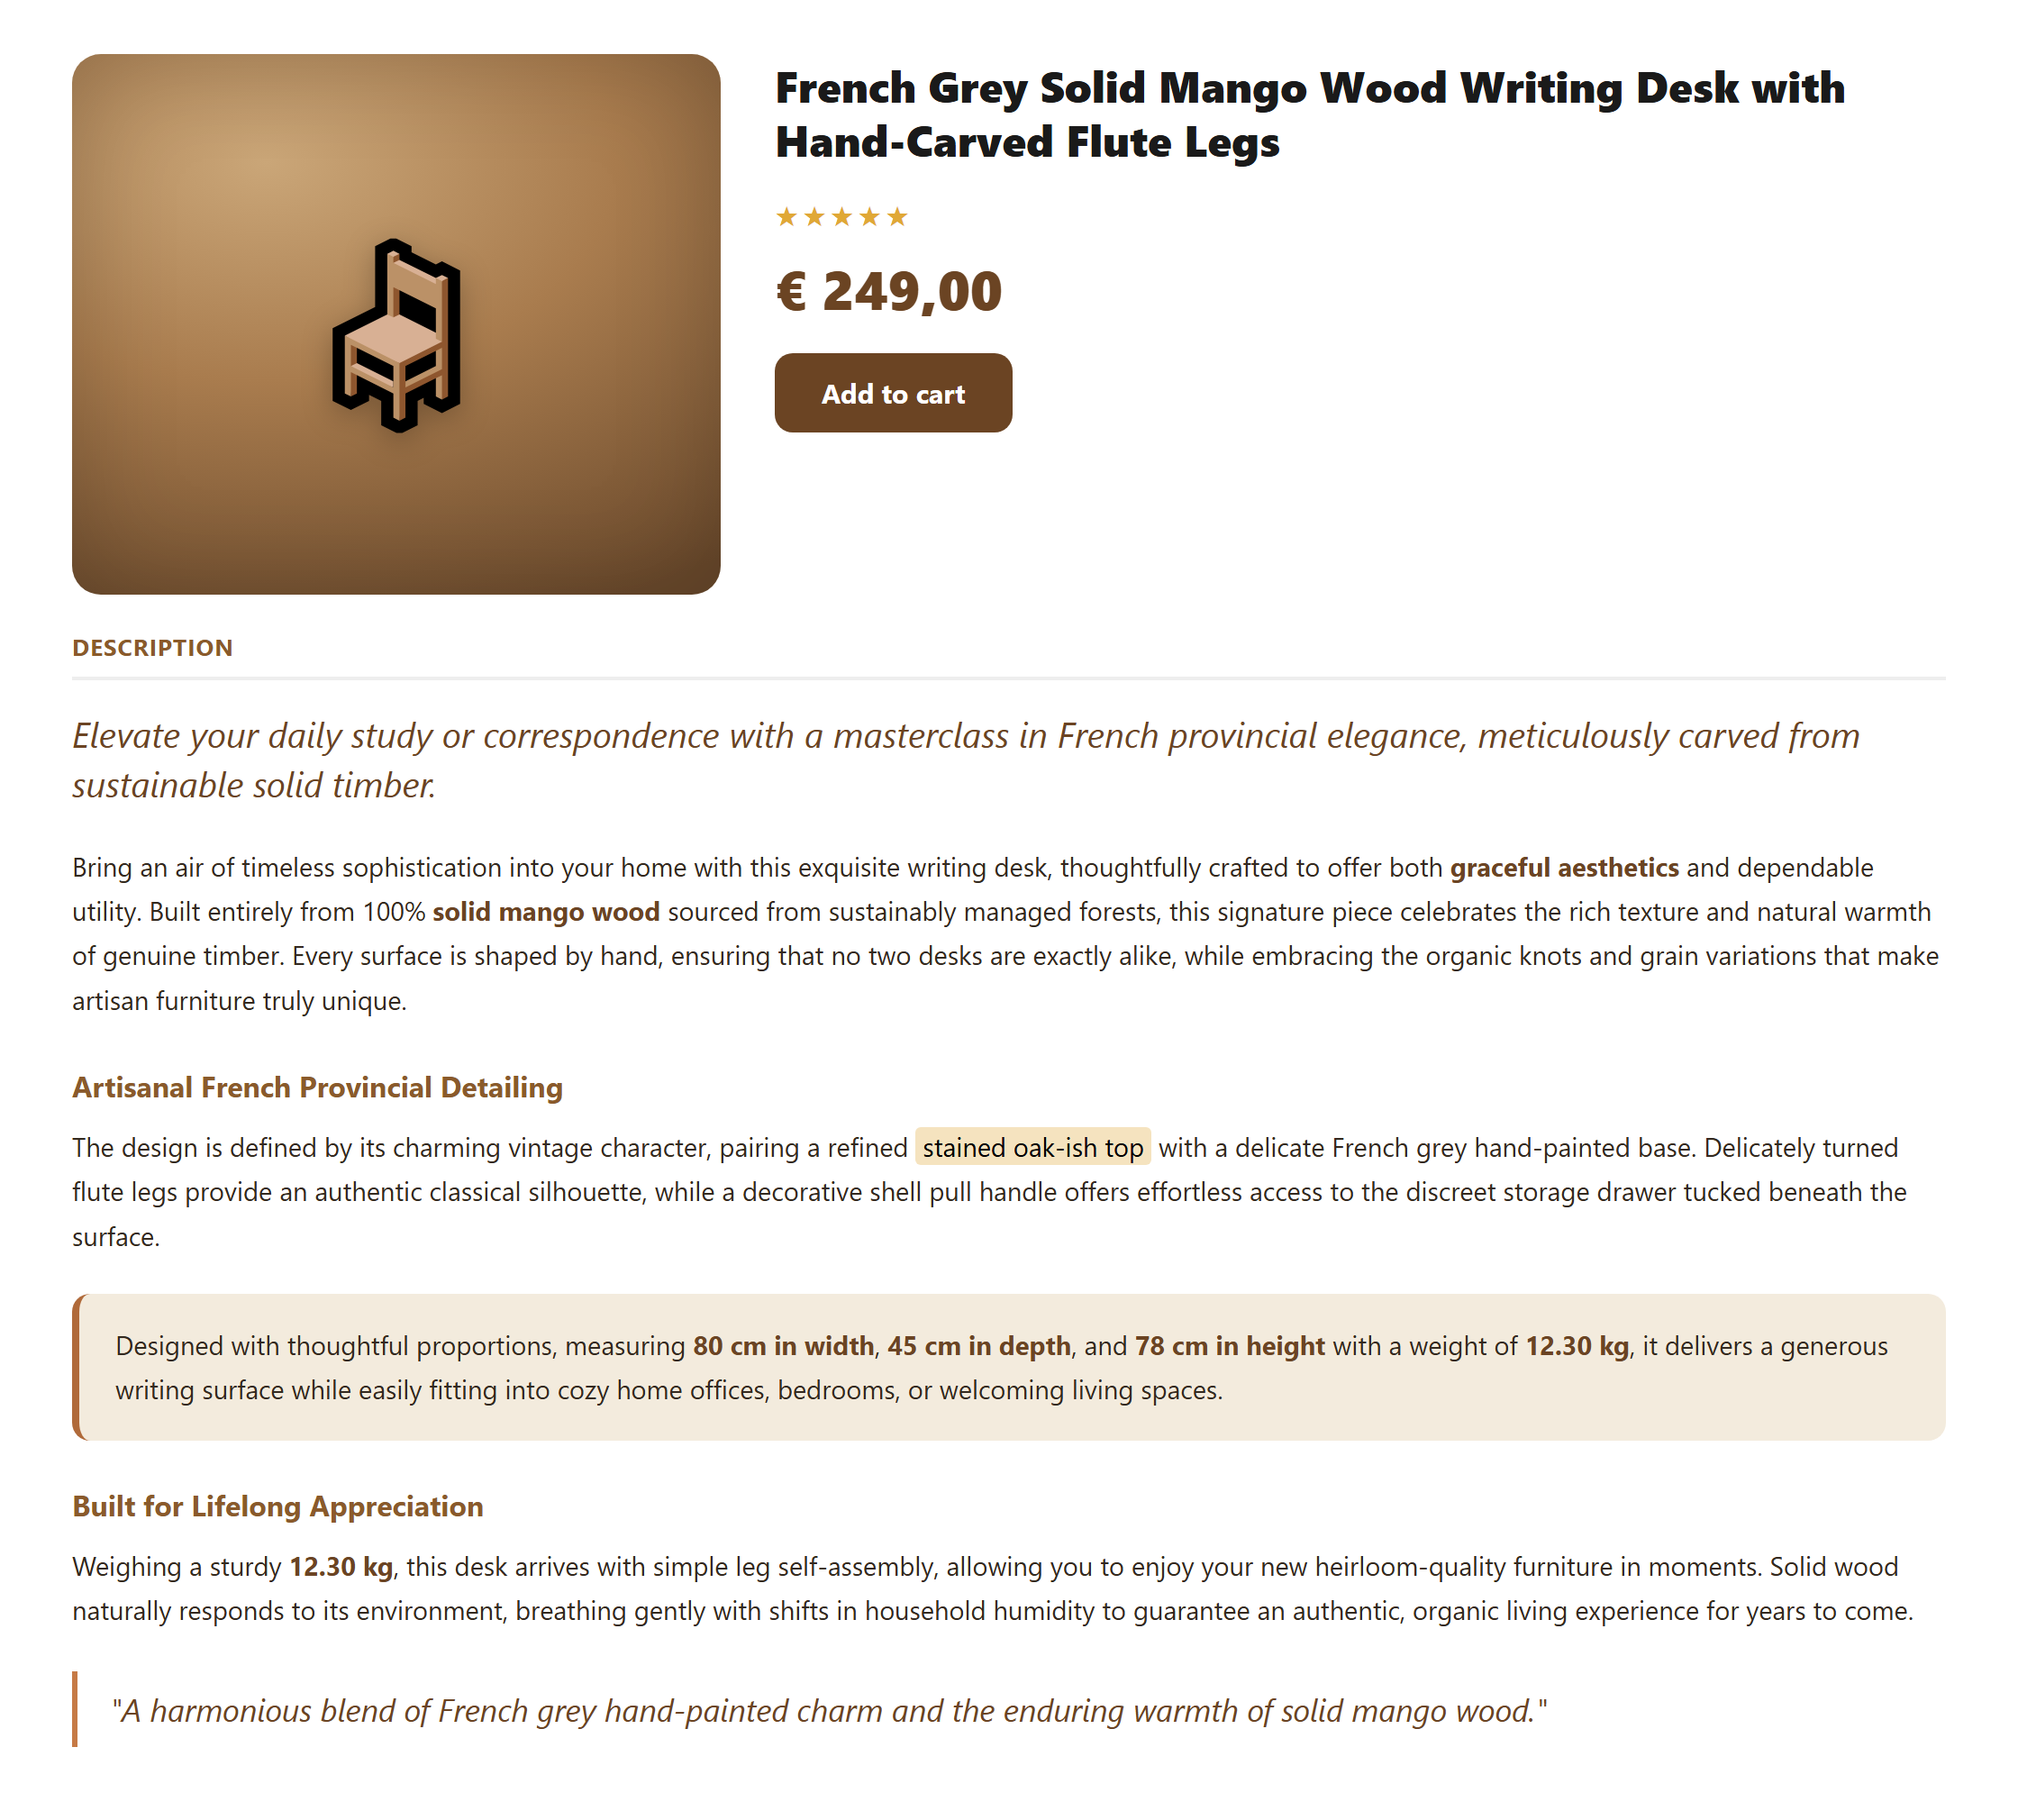
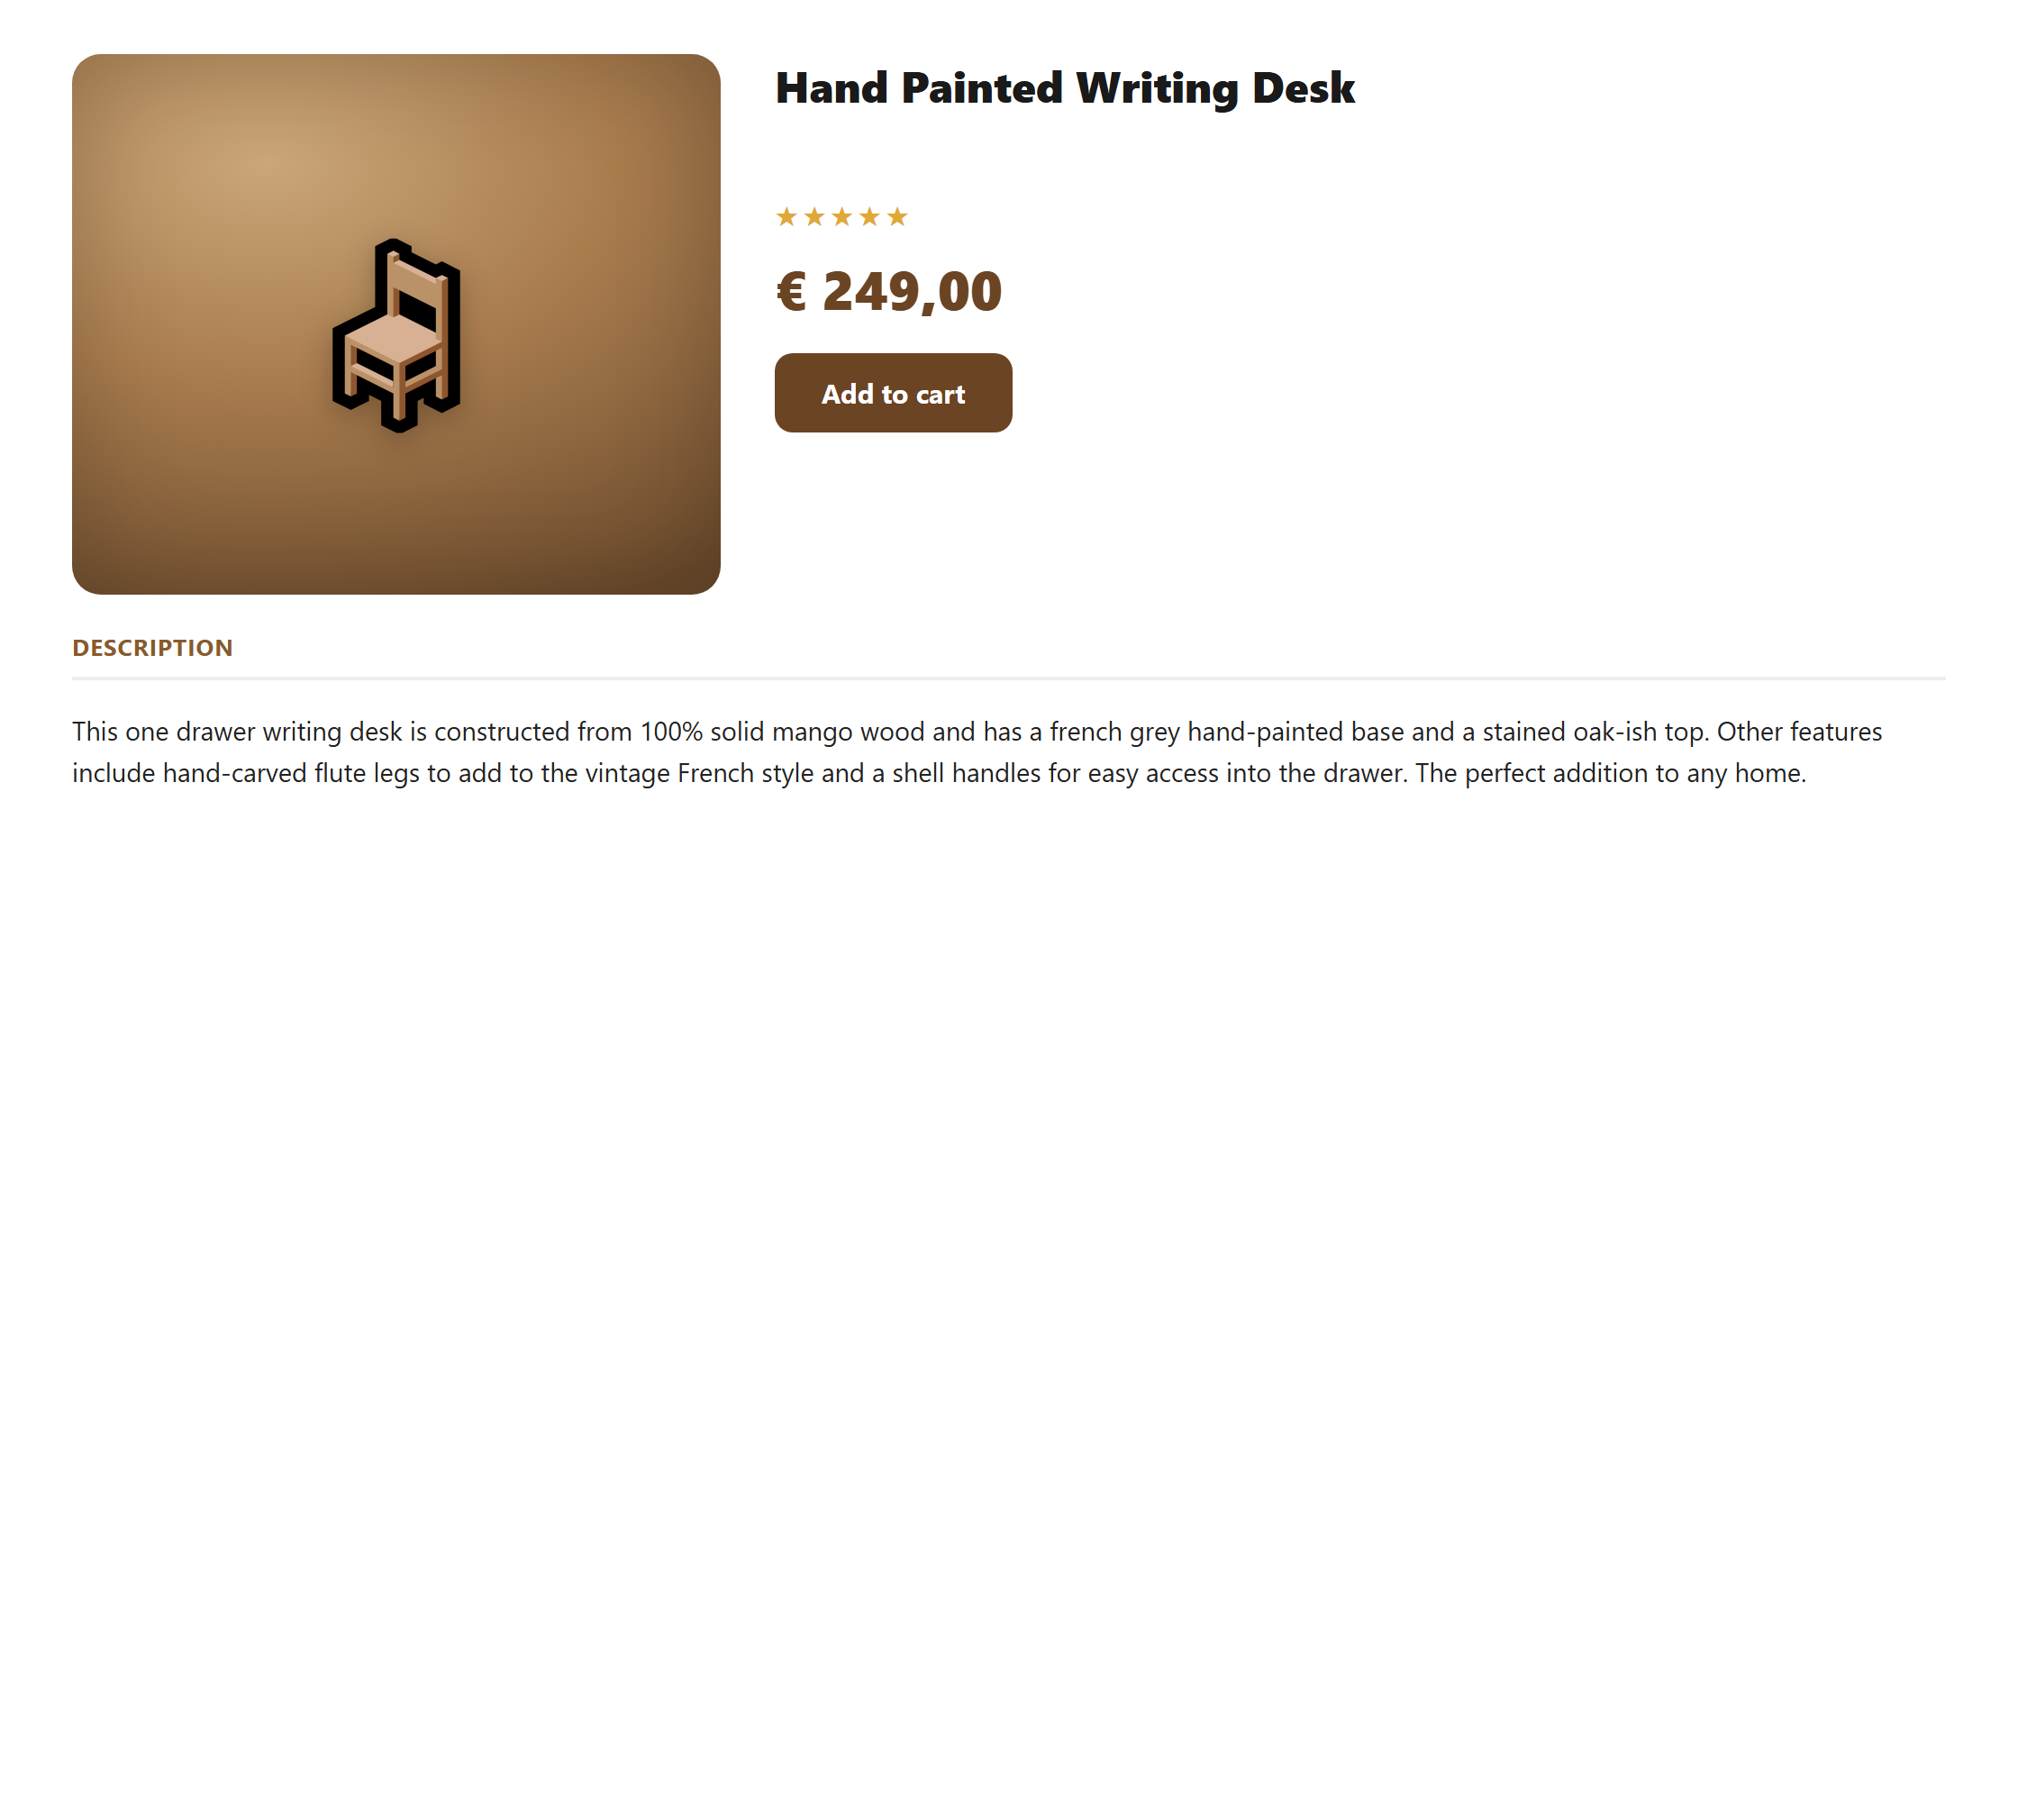
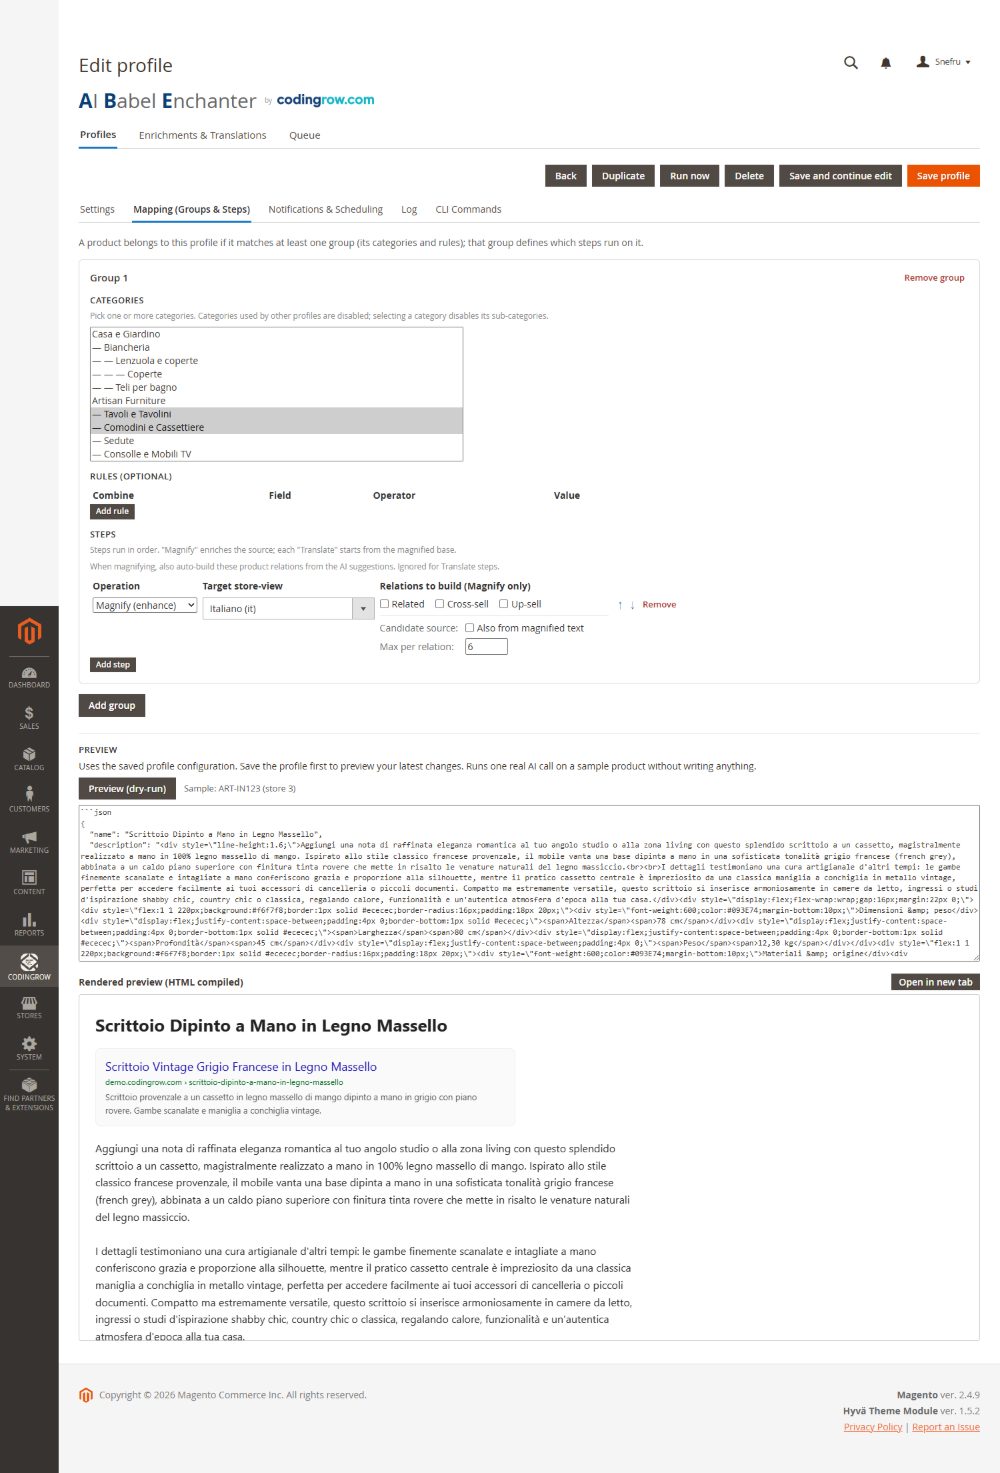
Antes de escrever seja o que for, execute um perfil em dry-run: o módulo gera o conteúdo proposto para uma amostra de produtos e mostra-o lado a lado com o texto atual, incluindo uma pré-visualização renderizada para que veja como a descrição melhorada vai realmente aparecer na página — não apenas o texto em bruto. Em dry-run nada é guardado; serve para validar o persona prompt e a pipeline antes de se comprometer com uma execução completa.
A grelha "Enrichments & Translations"
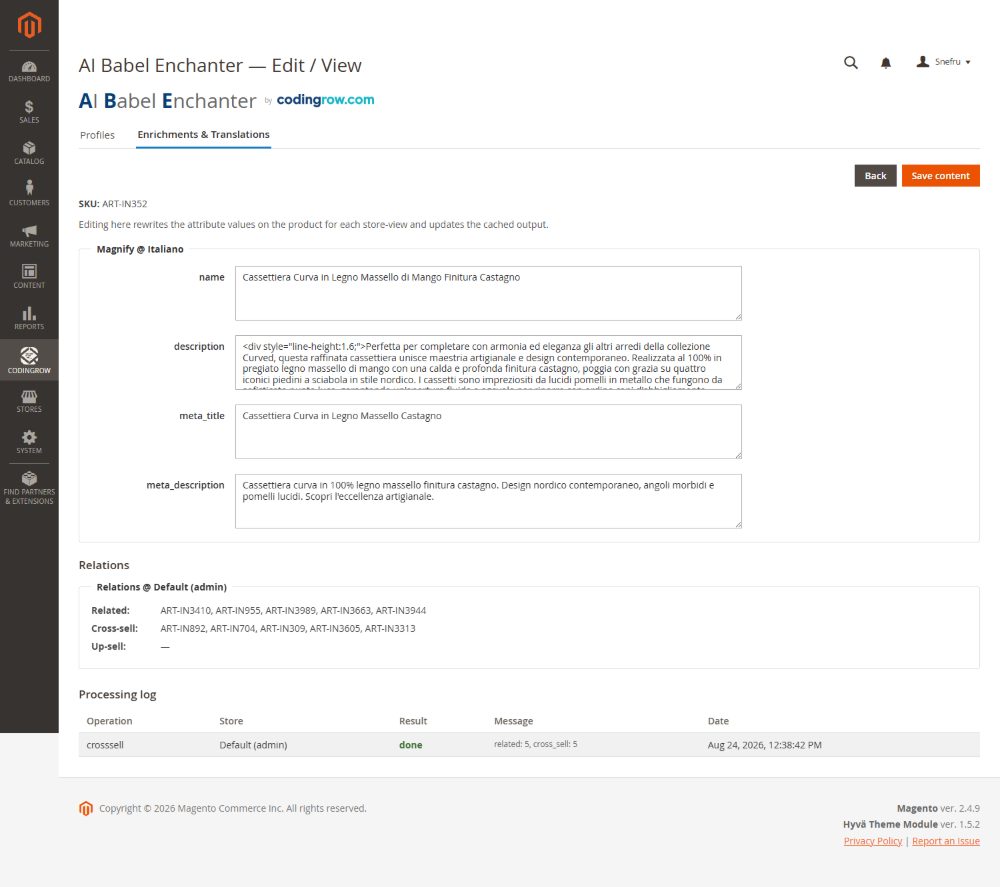
O separador "Enrichments & Translations" é a grelha de trabalho: cada campo gerado para cada produto e idioma, paginada e filtrável. Pode editar inline qualquer valor gerado antes ou depois de ser aplicado — a saída da IA é um ponto de partida, não um bloqueio — e cada linha mantém uma ligação ao texto original, para que possa restaurar o original desse campo com uma ação se o resultado não lhe agradar. É a camada human-in-the-loop por cima da pipeline automatizada.
Textos que declara definitivos
Mais cedo ou mais tarde aparece um produto cuja descrição acaba por escrever à mão: o artigo de bandeira, aquele a que o dono da loja dá importância, aquele em que o texto da IA ficou bom mas não ficou certo. Corrige-o à mão e, a partir desse momento, quer uma garantia — ninguém volta a reescrever isto. Essa garantia é a caixa Final, novidade da v3.4.0.
Abra Enrichments & Translations, abra um produto e, por baixo de cada campo, encontra uma caixa de verificação com a etiqueta “Final — never regenerate this text”. Marque-a e esse campo passa a ser seu.
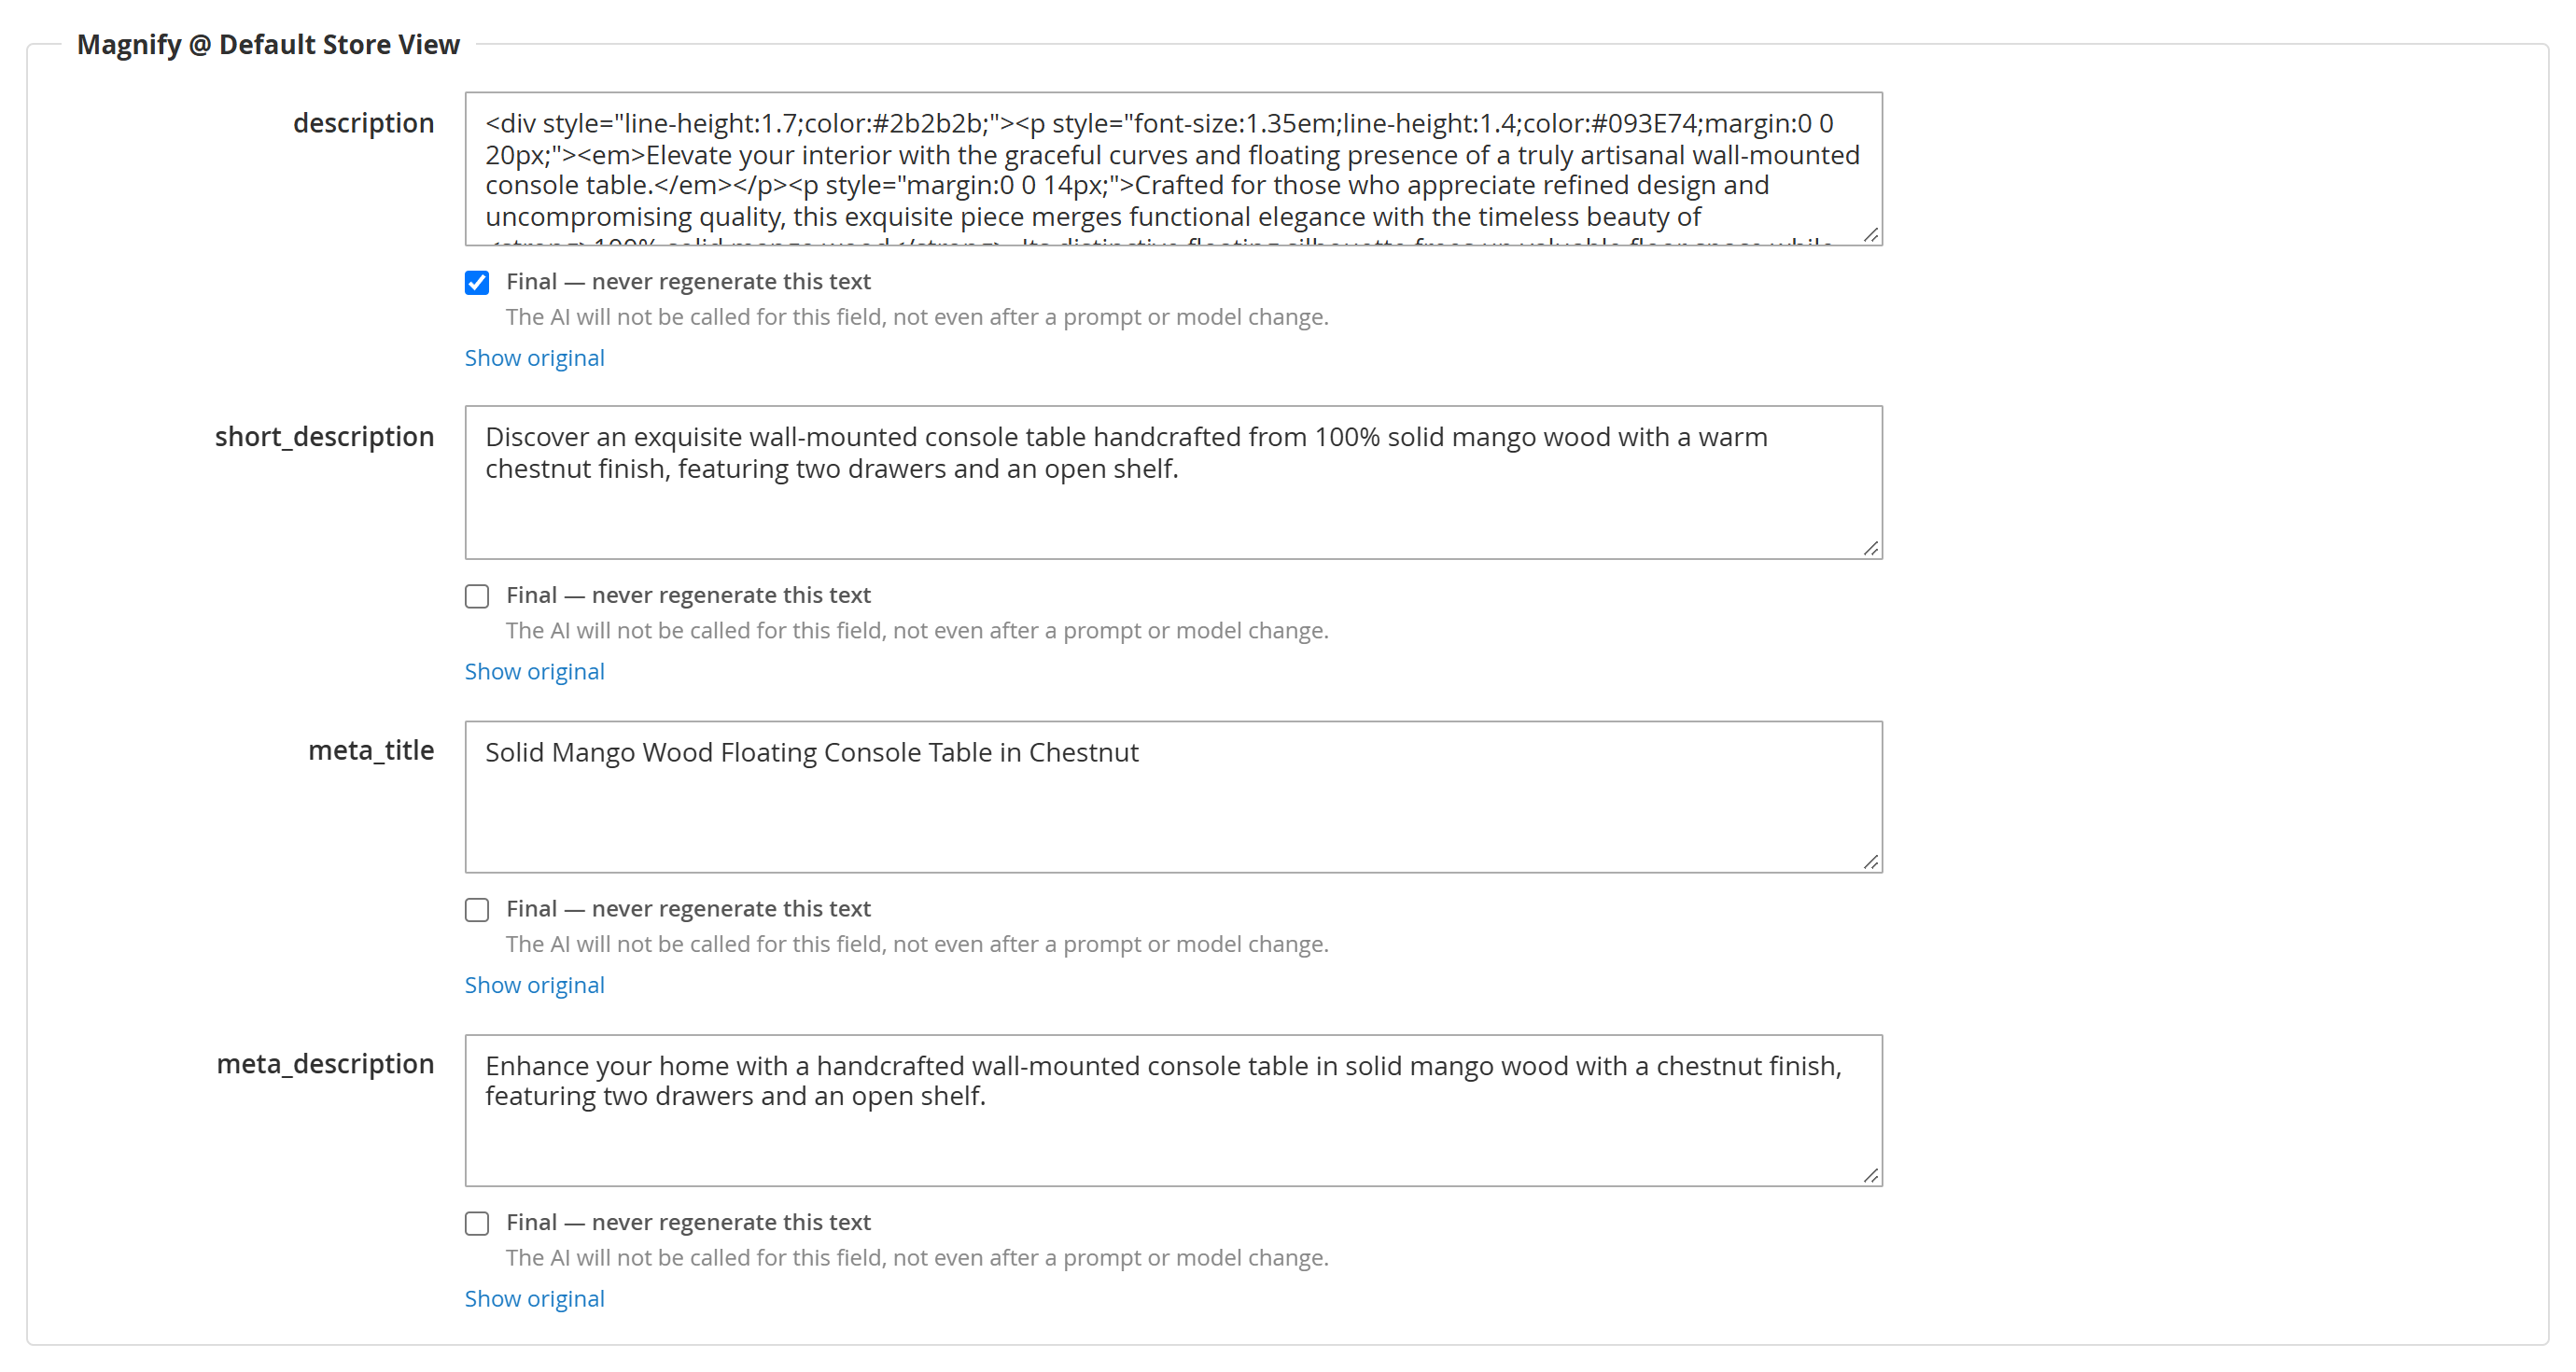
O que significa “final”, exatamente. Para esse campo, nesse produto, nessa vista de loja:
- a IA nunca mais é chamada para ele — nem na execução seguinte, nem depois de alterar o prompt da persona, nem depois de mudar de modelo, nem depois de limpar a cache, nem quando carrega em Apply to already processed. Não custa nada, para sempre. E se todos os campos de um produto estiverem declarados como finais, a chamada à IA para esse produto nem sequer chega a ser feita;
- se o valor desaparecer do produto — um importador sobrepôs-lhe outro, alguém restaurou o original, uma migração apagou-o — a verificação em segundo plano repõe o texto que declarou, também sem custo;
- ganha às regras automáticas do próprio módulo. O meta título, por exemplo, é normalmente forçado a seguir sempre o nome do produto; declare o meta título como final e o seu texto ganha até a essa regra;
- aplica-se apenas a esse campo. Os restantes campos do mesmo produto continuam a ser gerados normalmente. Declarar a descrição como final não congela o meta título e não retira o produto do perfil.
Editar na grelha marca-a por si. Assim que escreve num campo da grelha, a respetiva caixa Final marca-se sozinha. É o comportamento que a própria interface dá a entender — foi lá e corrigiu aquele texto, portanto a correção é a razão de ser de tudo — e antes da v3.4.0 não acontecia: um texto corrigido à mão sobrevivia até à alteração seguinte do prompt e era então regenerado por cima, em silêncio. Se quiser que um texto corrigido volte a ser gerado mais tarde, desmarque a caixa antes de gravar.
O que há a reter: um campo final é a única coisa no módulo que sobrevive a uma mudança de prompt de persona ou de modelo. Todo o resto é reconstruído a partir do resultado guardado, e o resultado guardado é arquivado sob uma chave que inclui o prompt inteiro — altere o prompt e nenhum dos resultados guardados pode ser reaproveitado.
Textos que voltam sozinhos
Eis uma falha que antes passava despercebida. Um produto já processado nunca volta a entrar na fila por iniciativa própria — de propósito, para que voltar a executar um perfil seja barato e seguro. O efeito colateral: se alguma coisa sobrepuser um texto gerado depois de o produto ter sido processado, esse produto nunca mais é olhado. A loja continua a mostrar o texto sobreposto, a fila diz done, o histórico continua a guardar o texto gerado e não é levantado qualquer erro em lado nenhum. Encontrámo-la num catálogo real: 318 produtos com títulos e descrições em inglês numa loja italiana, durante semanas, com o texto italiano ainda guardado no histórico do próprio módulo.
A v3.4.0 fecha esta porta. Uma verificação em segundo plano corre de hora a hora e faz uma única pergunta por resultado guardado, lendo apenas a base de dados e sem nunca chamar uma IA para a responder: o texto que escrevi ainda está no produto? Quando a resposta é não, o produto regressa à fila com o tratamento mais barato que se lhe aplique:
| O que a verificação encontra num produto | O que faz | Quanto custa |
|---|---|---|
| pelo menos um dos campos em falta está declarado como final | repõe imediatamente o texto que declarou | nada, sempre |
| os campos mudaram, mas o texto de origem está igual | reaproveita o resultado guardado — sem chamada à IA | nada |
| os campos mudaram e o texto de origem mudou mesmo | regenera-os: trata-se de material novo do produto | uma chamada paga à IA — sujeita ao limite |
Funciona por fatias, e isto importa. Cada execução examina 500 resultados guardados e lembra-se de onde parou, retomando daí uma hora mais tarde. A comparação custa duas consultas por linha, por isso varrer um catálogo grande a cada hora seria um peso que ninguém pediu. O catálogo inteiro continua a ser coberto — apenas distribuído ao longo do tempo. Num catálogo grande, isso significa que um texto que tenha desaparecido pode esperar horas e, num catálogo muito grande, um par de dias, até a verificação lhe chegar. Não está bloqueado: ainda não lá chegou. Se precisa de uma resposta já, bin/magento babel:reapply olha imediatamente para aquilo que lhe indicar.
Controla-a em Stores → Configuration → Codingrow → AI Babel Enchanter → Keeping the texts in place:
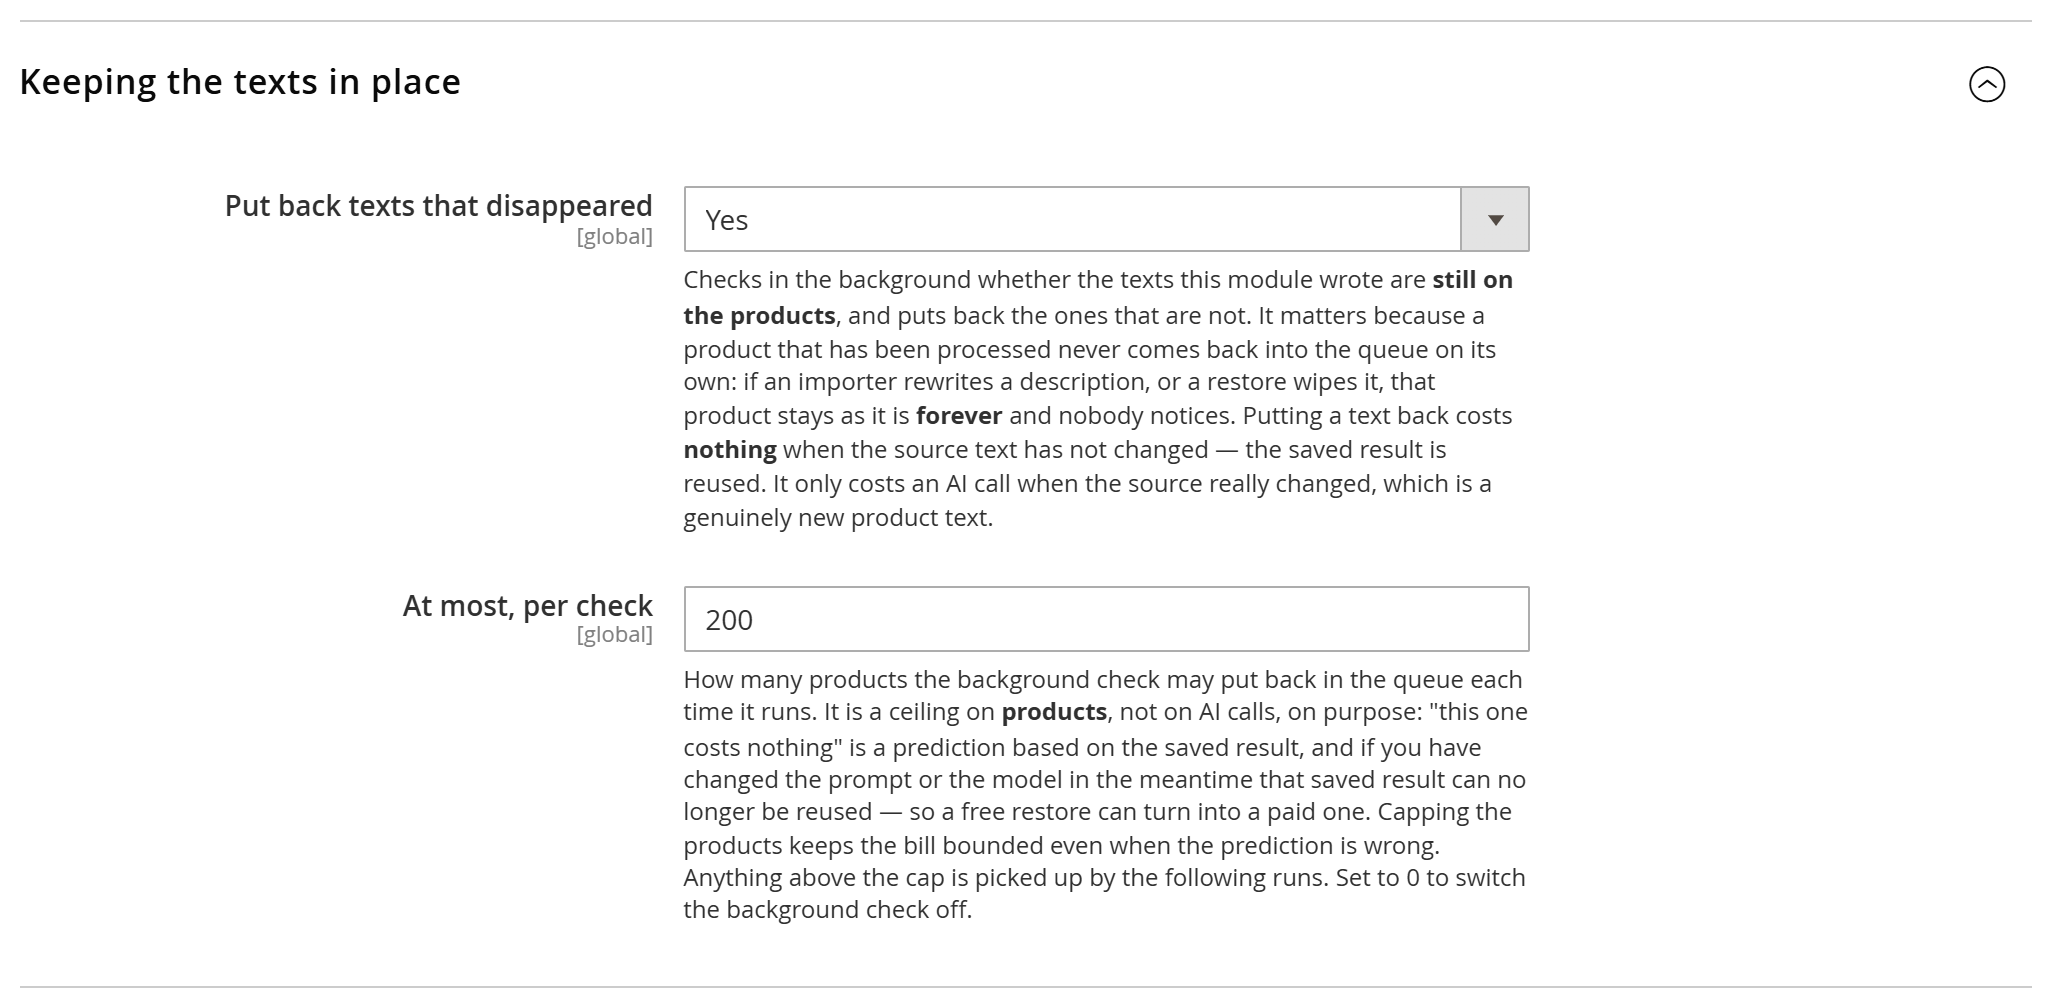
- Put back texts that disappeared — Yes por predefinição. Ponha-a em No e nada volta a ser reposto automaticamente; fica-lhe o comando
babel:reapplypara as passagens manuais. - At most, per check — 200 por predefinição. Tudo o que exceda o limite é apanhado nas execuções seguintes. Ponha-o a 0 para desligar a verificação em segundo plano.
Porque é que o limite conta produtos e não chamadas à IA. “Este não custa nada” é uma previsão baseada no resultado guardado. Se entretanto alterou o prompt ou o modelo, esse resultado guardado já não pode ser reaproveitado e uma reposição que parecia gratuita passa a ser paga. Limitar produtos mantém a fatura sob controlo mesmo quando a previsão falha. As reposições gratuitas são processadas primeiro, por isso o trabalho barato fica sempre feito antes de o limite ser atingido.
O que não faz, e o que faz. Nunca mexe em preços, existências, imagens nem em qualquer atributo fora dos que o perfil gere, e nunca inscreve um produto que nunca tenha sido processado. Mas convém ser claro quanto à parte que apanha as pessoas de surpresa: o que volta à fila é o produto, e a execução reescreve depois todos os campos que esse perfil gere. Por isso, se tinha corrigido um desses campos na página do produto, essa correção é substituída. Isto não é um defeito, é a regra dos dois canais: uma correção que quer ver mantida pertence à grelha, ou leva a marca Final.
Na linha de comandos, bin/magento babel:reapply limita-se a relatar e não escreve nada a menos que lhe passe --confirm — a forma segura de ver o estado de um catálogo antes de decidir. Acrescente --only-free para as reposições que não custam nada, --profile e --limit para restringir a passagem.
Aplicar um novo prompt aos produtos já feitos
Os perfis são deliberadamente avessos a refazer trabalho: um produto já processado não volta a ser processado, e é isso que torna seguro e barato voltar a executar um perfil. O reverso da medalha é que, quando melhora o prompt da persona, a melhoria só chega aos produtos processados daí em diante — tudo o que já estava feito mantém o texto antigo. Até à v3.4.0, a única forma de os incluir era babel:run --force a partir da linha de comandos.
Agora a página do perfil tem um botão para isso.

Apply to already processed devolve à fila desse perfil os produtos marcados como done, partial e skipped. A confirmação diz o custo por palavras simples antes de acontecer seja o que for: “Os produtos cujo texto de origem não mudou são reaproveitados sem custo. Os restantes são reescritos pela IA, o que o seu fornecedor lhe fatura, por isso, depois de mudar a persona ou as instruções, conte com a reescrita do perfil inteiro.”
Essa última frase não é texto de circunstância. Cada resultado de enriquecimento é arquivado sob uma chave que inclui o fornecedor, o modelo e o prompt de sistema inteiro. Mude a persona, mude o template, mude o modelo e nem um único resultado de enriquecimento do catálogo pode ser reaproveitado — e as traduções vão atrás, porque aquilo que traduzem acabou de mudar. Carregar neste botão depois de uma mudança de prompt significa, portanto, “regenera este perfil todo, e paga por isso”. Antes de uma mudança de prompt, num catálogo intocado, o mesmo botão é quase gratuito.
Use-o quando melhorou o prompt e quer pôr os produtos antigos ao nível do novo padrão; quando acrescentou um atributo a um grupo e o quer ver preenchido em todo o lado; quando corrigiu um erro de mapeamento. Não o use quando só quer reparar textos que desapareceram — para isso existe a verificação em segundo plano descrita acima, e é muito mais barata.
Os campos declarados Final também não são regenerados por este botão.
Se o seu catálogo é importado
Se os produtos chegam ao Magento a partir de um feed de fornecedor, de um ERP, de um PIM ou de qualquer importação agendada, esse importador e o Babel escrevem nos mesmos campos. Que os dois convivam em paz depende de como o importador está configurado e de quantas vistas de loja tem — e, quando não convivem, o sintoma não é uma mensagem de erro: é o texto que pagou a desaparecer em silêncio enquanto todos os ecrãs continuam a dar conta de sucesso.
O teste de aceitação demora um minuto: enriqueça um produto, corra a importação sem alterar nada no feed, recarregue o produto. Se o texto do Babel continuar lá, esse importador é compatível. Se o texto do fornecedor estiver de volta, não é — e nenhuma definição do Babel resolve isso.
Rollback
Cada valor que o módulo escreve é reversível. Além do restaurar original por linha na grelha, o comando CLI babel:rollback reverte o conteúdo em bloco — por perfil, por produto ou de toda a execução — para o texto que existia antes de o módulo intervir. Como o original é sempre preservado, uma execução sobre todo o catálogo nunca é uma porta de sentido único.
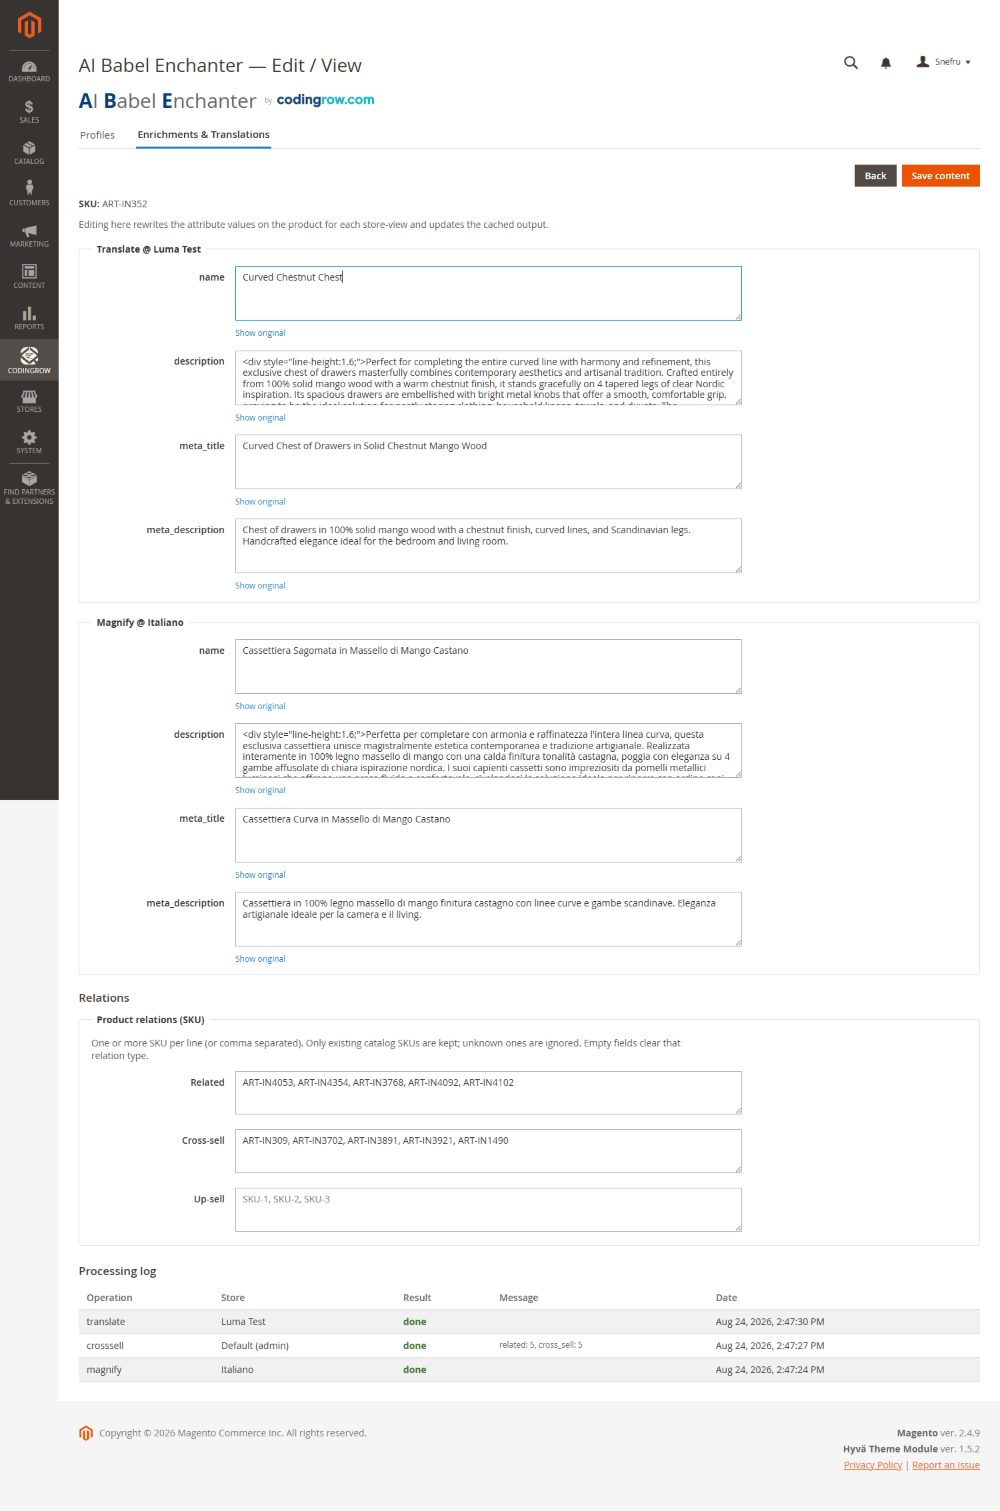
Queue e circuit breaker de créditos
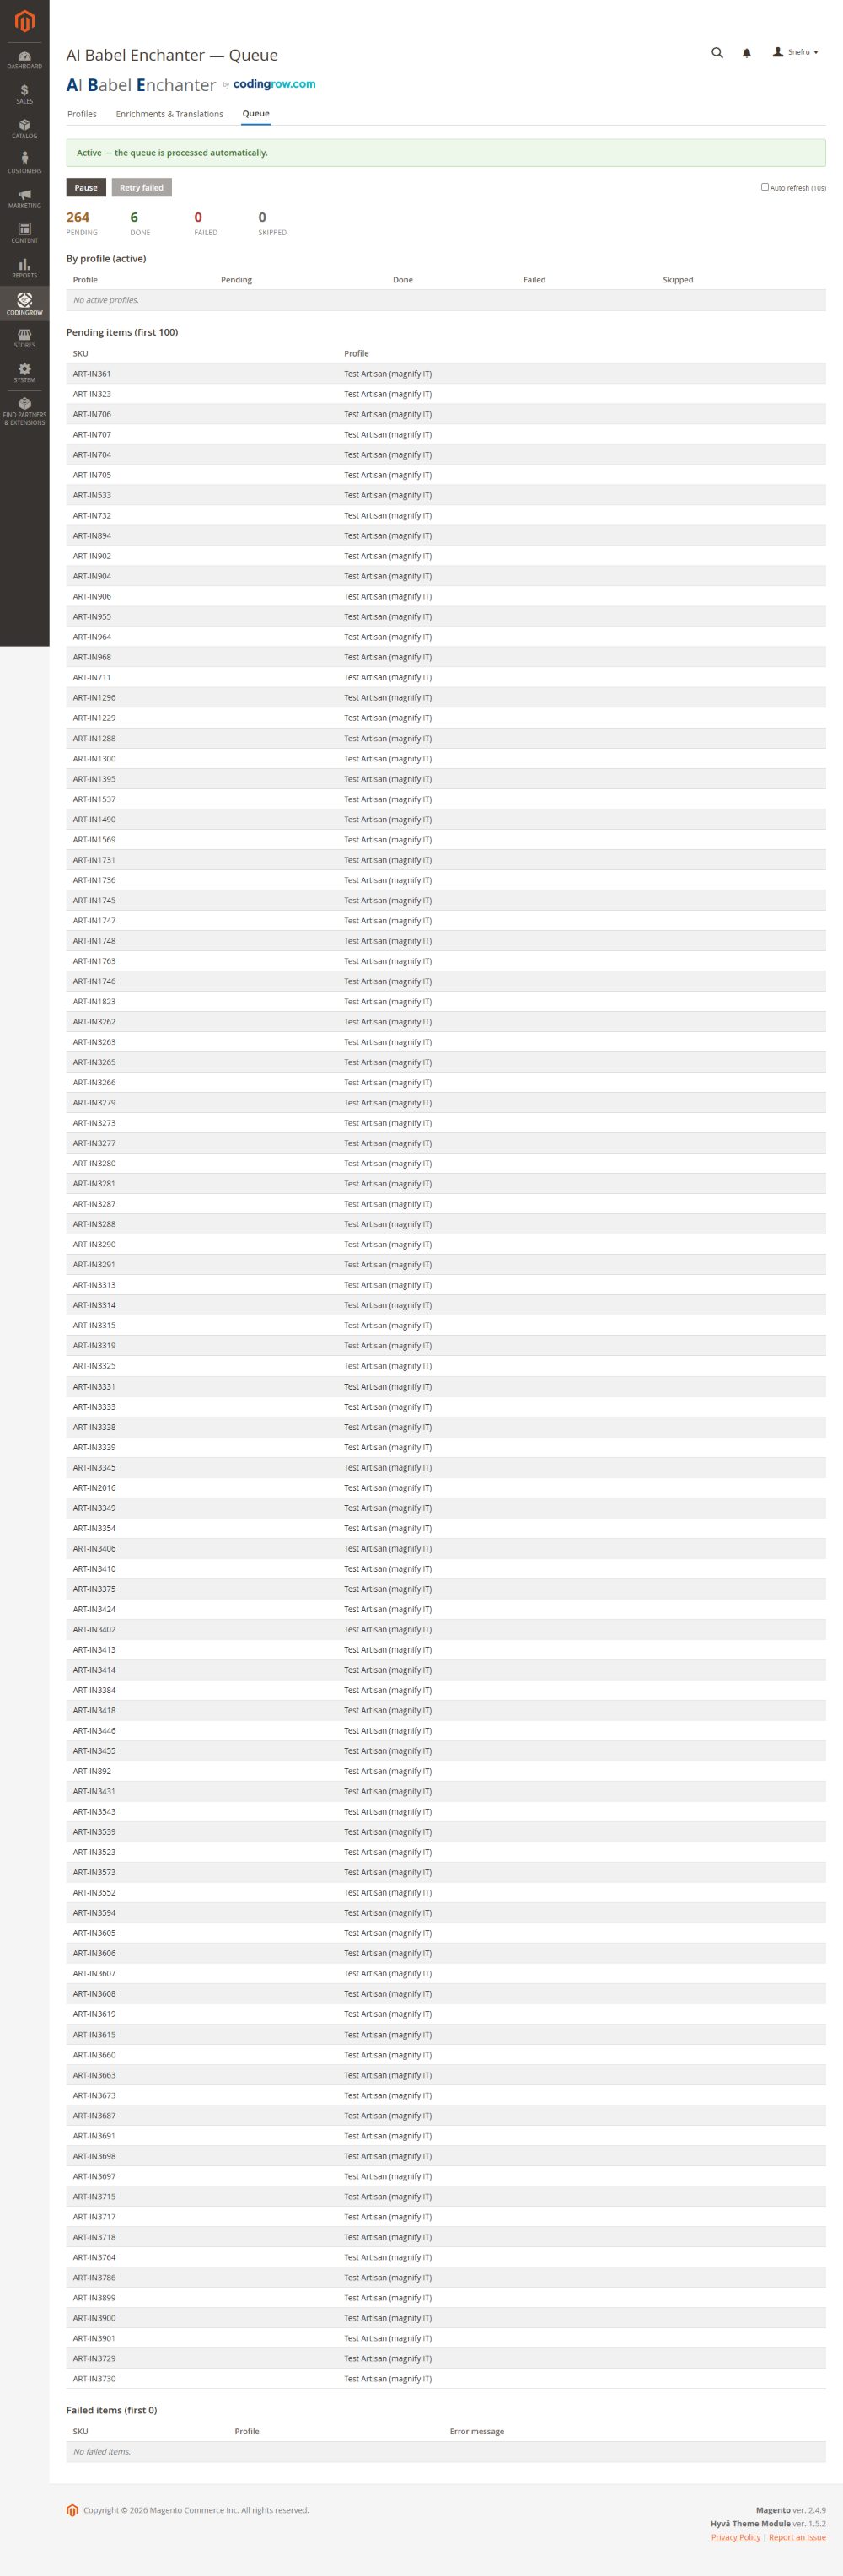
As execuções longas são processadas através de uma fila que pode observar, pausar e retomar. O circuit breaker integrado (configurado em Resilience) protege a execução: perante erros repetidos do provedor — na maioria das vezes o provedor sem crédito ou em rate limit — pausa após N erros, aguarda o cooldown configurado e pode repetir automaticamente as falhas transitórias em vez de fazer falhar todo o lote. Quando recarrega crédito ou o limite é reposto, retome a fila e continua de onde parou.
Fichas de comerciante: devoluções e envio
O Google lê da página do produto as condições de devolução e de envio para mostrá-las nas suas fichas de comerciante gratuitas, e o Search Console as aponta como ausentes quando não estão lá. Não dá para deduzi-las do catálogo — são condições comerciais — então são declaradas na configuração, em Merchant listings (returns and shipping). Os dois blocos vêm desligados e exigem os dados estruturados do produto ativos.
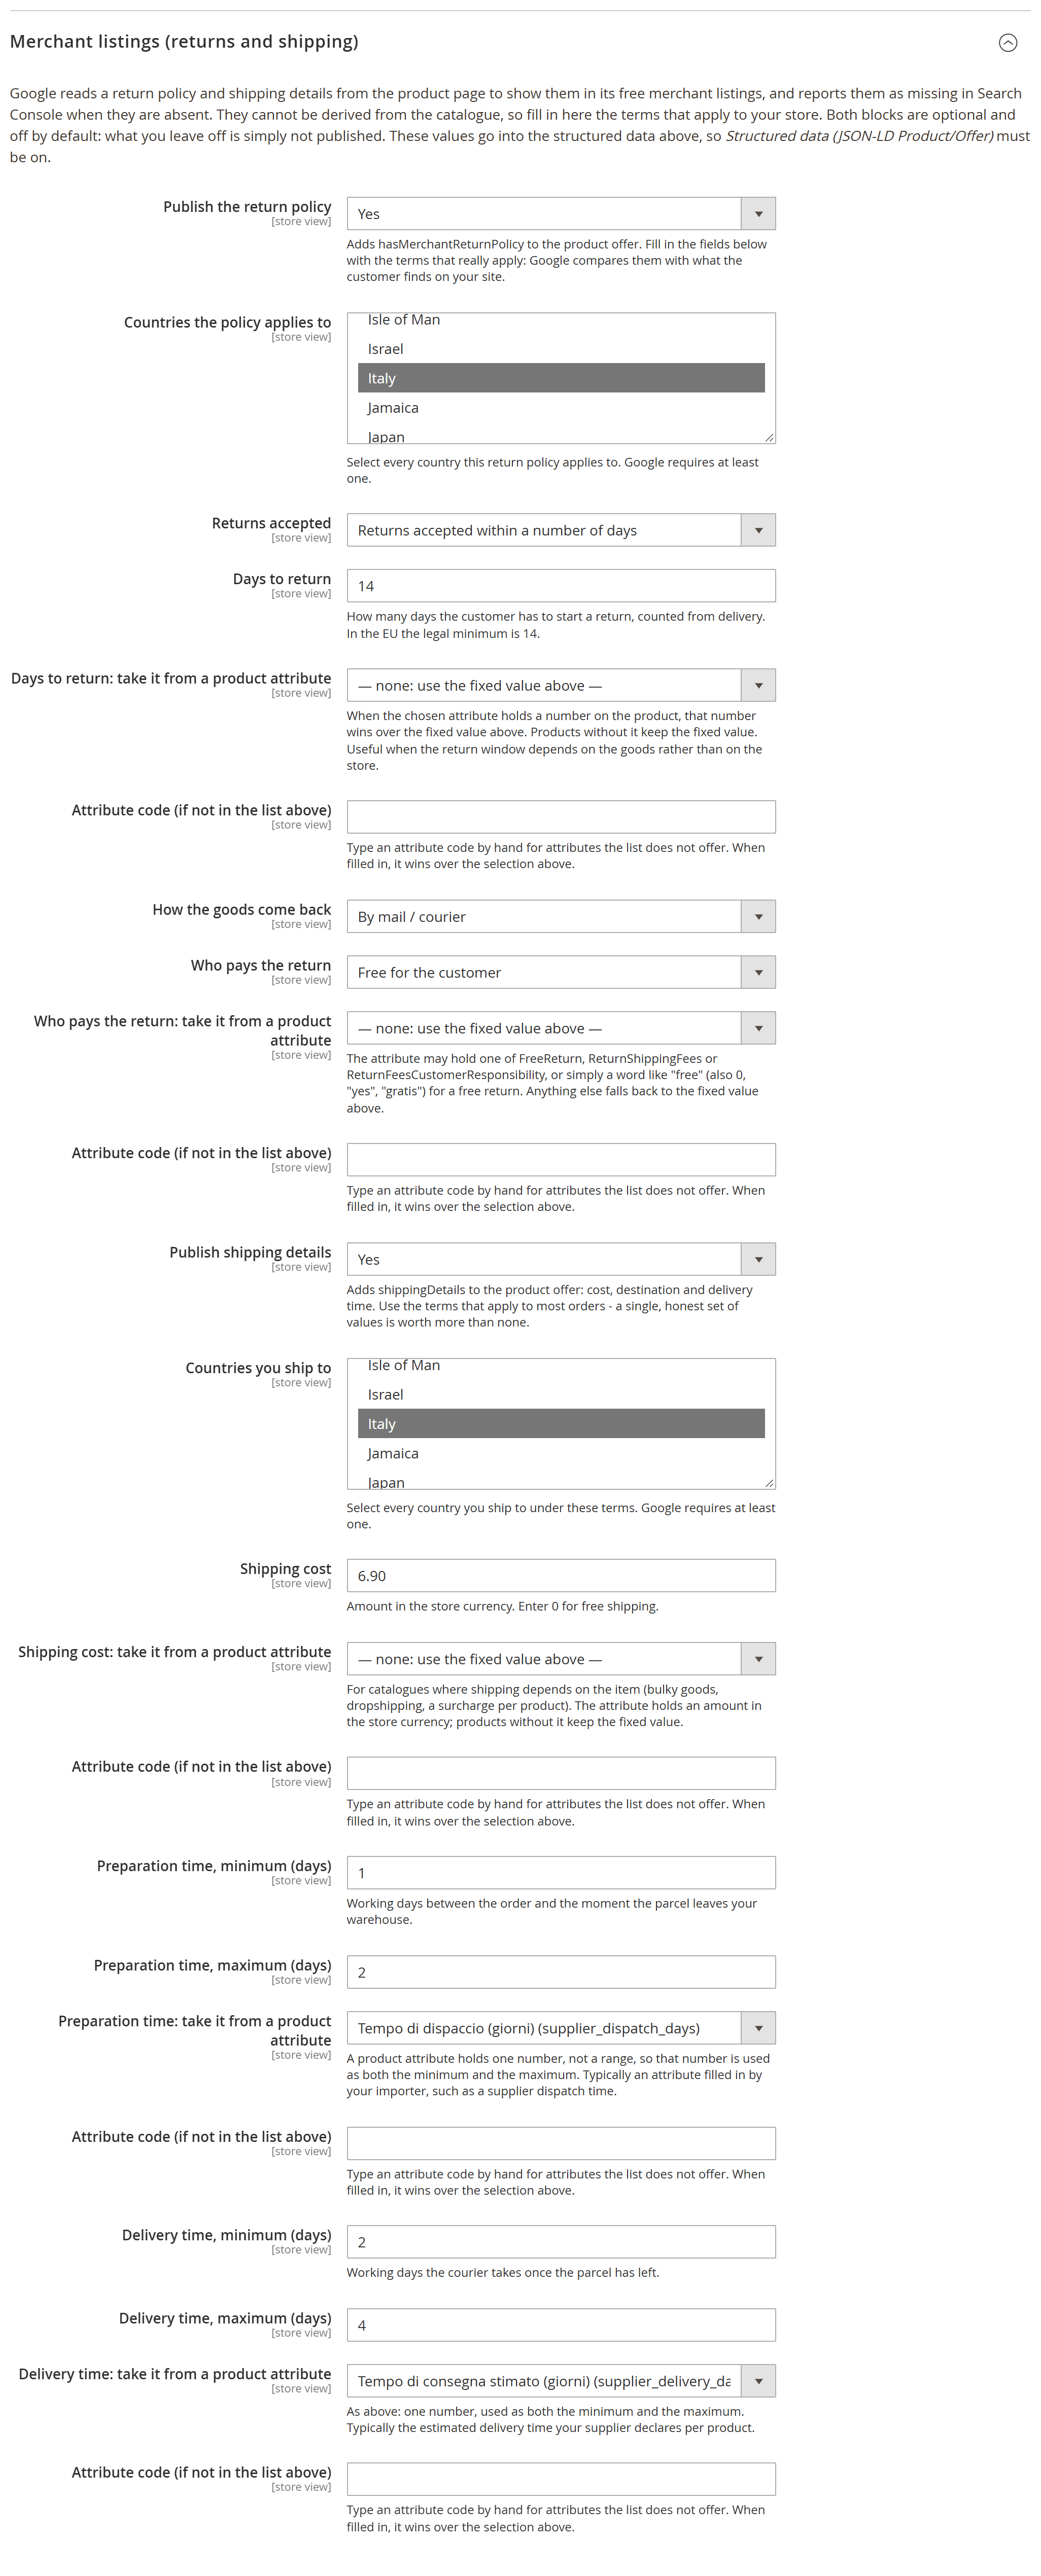
- Condições de devolução →
hasMerchantReturnPolicy: países (escolhidos na lista do Magento), prazo de devolução, dias, como a mercadoria volta, quem paga e o custo quando houver. - Condições de envio →
shippingDetails: países atendidos, custo (0para envio gratuito), prazos de preparação e entrega em dias úteis.
Duas regras são propositais. Um bloco com campos obrigatórios incompletos é descartado inteiro em vez de publicado pela metade: o Google compara o que você declara com o que o cliente encontra no seu site, então uma declaração errada vale menos do que uma ausente. E com "devoluções não aceitas" não se publica nem o método nem quem paga: não há devolução a descrever.
A oferta traz também validFrom, a data a partir da qual o preço publicado vale: o início do preço especial quando existe, caso contrário a data de criação do produto. Essa não precisa de configuração.
Quase nunca essas condições valem para o catálogo inteiro: os prazos de preparação e entrega mudam entre estoque próprio e dropshipping, o envio depende do volume, o prazo de devolução do que se vende. E o número normalmente já existe no produto, num atributo que o seu importador ou a sua equipe preenche. Por isso cada um desses campos pode apontar para um atributo do produto — a lista inclui os personalizados — com uma caixa para digitar um código que a lista não oferece. Onde o produto tem um valor, vence ele; onde não tem, fica o valor fixo; e um valor que não é um número recai no fixo em vez de publicar um absurdo.
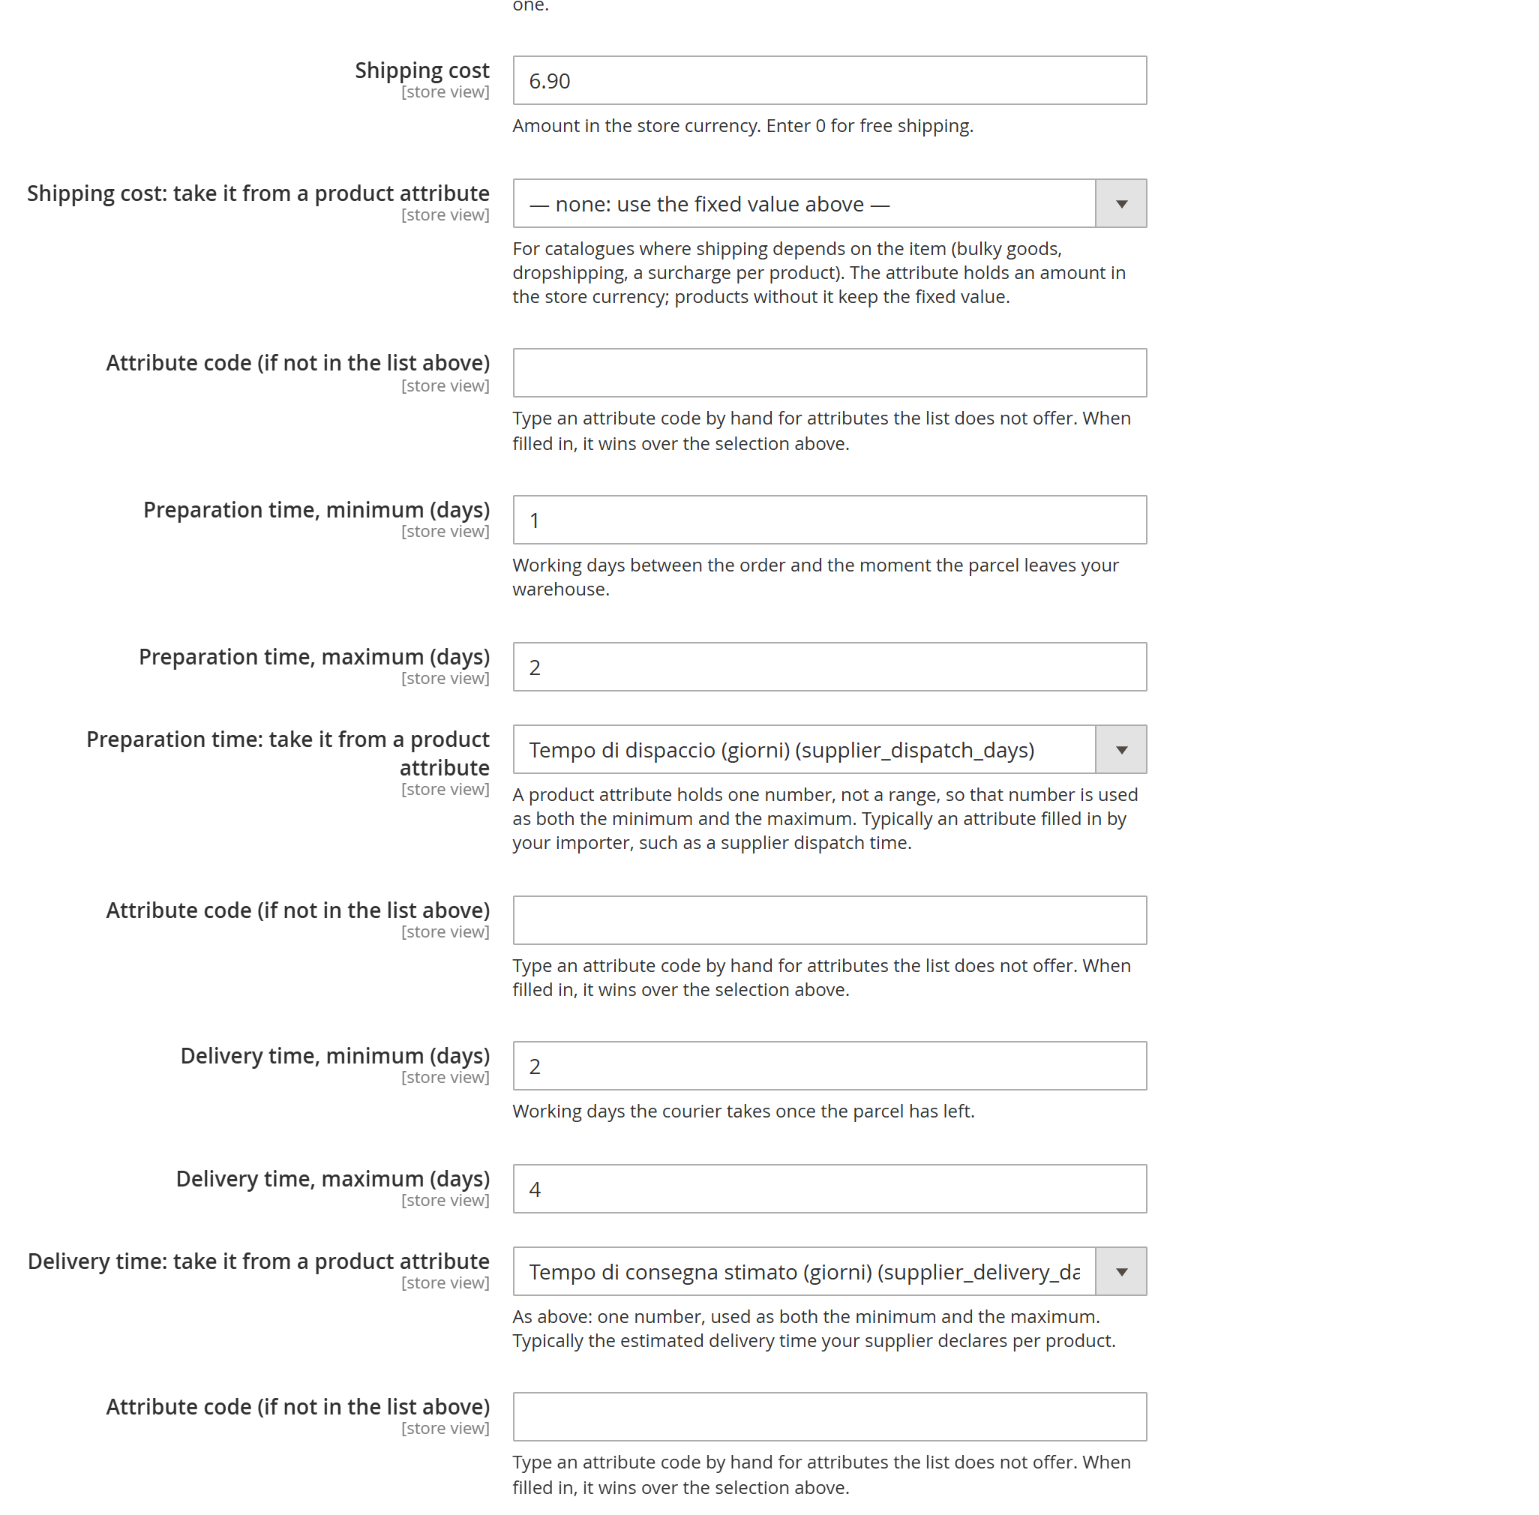
Cada número pode vir de um atributo do produto, escolhido na lista do catálogo: aqui os prazos de preparação e entrega vêm dos atributos que um importador preenche.
Linha de comandos (CLI)
Tudo pode ser conduzido a partir da CLI para agendamento e execuções grandes.
| Comando | O que faz |
|---|---|
bin/magento babel:run | Executa um perfil (pipeline melhorar/traduzir) sobre os seus produtos de destino — a forma padrão de lançar uma passagem sobre todo o catálogo. |
bin/magento babel:rollback | Reverte o conteúdo gerado para o texto original, com âmbito por perfil, produto ou toda a execução. |
bin/magento babel:queue | Inspeciona e controla a fila de processamento: estado, pausa, retoma. |