Installation
Prérequis
Magento 2.4.x — testé sur 2.4.9, compatible avec les versions 2.4.* précédentes. PHP 8.1–8.5. Fonctionne aussi bien avec le thème par défaut Luma qu'avec le thème Hyvä — le module s'exécute entièrement dans l'admin et écrit des attributs de catalogue standard, de sorte que votre storefront affiche le contenu amélioré sans modification des templates. Dépend du module gratuit codingrow/module-core, installé automatiquement. Nécessite une clé API d'au moins un fournisseur d'IA pour l'étape d'amélioration/réécriture (Anthropic, OpenAI, Google ou OpenRouter) et, pour la traduction, soit une clé de traduction automatique (DeepL), soit un LLM utilisé comme traducteur. Toute l'utilisation d'IA et de traduction vous est facturée directement par le fournisseur — Codingrow n'applique jamais de marge.
Étapes d'installation
- Ajoutez les identifiants que vous recevrez par e-mail au fichier
auth.jsonà la racine de votre projet Magento :{ "http-basic": { "repo.codingrow.com": { "username": "...", "password": "..." } } } composer config repositories.codingrow composer https://repo.codingrow.comcomposer require codingrow/module-ai-babel-enchanterbin/magento module:enable Codingrow_BabelEnchanterbin/magento setup:upgrade && bin/magento setup:di:compile && bin/magento cache:flush(setup:di:compileest requis pour un déploiement en production ; vous pouvez l'ignorer sur un environnement de développement)- Collez votre clé de licence dans Admin → Stores → Configuration → Codingrow → AI Babel Enchanter → License → License Key, enregistrez, puis videz le cache.
Configuration
Stores → Configuration → Codingrow → AI Babel Enchanter.
| Réglage | Ce que ça fait | Par défaut | Notes |
|---|---|---|---|
| License Key | La clé de licence émise pour ce domaine. | — | Accepte une clé de module unique ou une clé d'abonnement Codingrow. Sans licence valide, le module ne fonctionne pas. |
| Enable | Interrupteur principal du module. | No | Nécessite une licence valide et au moins une clé API de fournisseur. |
| Enhancement provider | Fournisseur, modèle et clé API qui réécrivent et améliorent le texte (le moteur d'amélioration/réécriture). | — | Utilisez Load models à côté du champ Model au lieu de saisir un id. |
| Translation provider | Comment les langues cibles sont produites : un service de traduction automatique (DeepL) ou un LLM utilisé comme traducteur, avec son modèle et sa clé. | — | Traduisez avec le même LLM que l'étape d'amélioration, ou avec une clé MT dédiée pour un coût par caractère plus bas. |
| SEO options | Interrupteurs pour ce qui est généré : meta title, meta description, meta keywords, URL key. | — | Désactivez tout ce que vous ne voulez pas que le module touche. |
| Resilience | Circuit breaker : nouvelle tentative automatique en cas d'échec transitoire, heures de cooldown avant de réessayer, pause après N erreurs consécutives. | — | Protège une longue exécution quand le fournisseur n'a plus de crédit ou applique un rate limit. |
Désinstallation
Mettez Enable sur No et enregistrez pour arrêter immédiatement tout traitement — le contenu de votre catalogue reste exactement tel quel. Si vous voulez d'abord revenir au texte original, lancez un rollback (voir le Guide utilisateur). Pour supprimer entièrement le module : bin/magento module:disable Codingrow_BabelEnchanter puis composer remove codingrow/module-ai-babel-enchanter.
Fournisseurs & coût
Choisir les fournisseurs
AI Babel Enchanter dispose de deux emplacements de fournisseur indépendants : un pour l'étape d'amélioration/réécriture (un LLM) et un pour la traduction (un LLM ou un service dédié de traduction automatique comme DeepL). Vous apportez vos clés et toute l'utilisation vous est facturée directement par le fournisseur que vous choisissez — Codingrow n'applique jamais de marge. Choisissez le modèle d'amélioration pour la qualité et traduisez avec le même LLM ou avec une clé MT moins chère au caractère.
Anthropic (modèles Claude)
- Connectez-vous sur console.anthropic.com.
- Allez sur console.anthropic.com/settings/keys.
- Cliquez sur Create Key, nommez-la (p. ex. "AI Babel Enchanter") et copiez la valeur.
- Collez-la dans l'emplacement de fournisseur avec Provider réglé sur Anthropic, puis utilisez Load models.
OpenAI (modèles GPT)
- Connectez-vous sur platform.openai.com.
- Allez sur platform.openai.com/api-keys.
- Cliquez sur Create new secret key, nommez-la et copiez-la immédiatement — elle n'est affichée qu'une seule fois.
- Collez-la dans l'emplacement de fournisseur avec Provider réglé sur OpenAI, puis utilisez Load models.
Google (modèles Gemini)
- Connectez-vous sur aistudio.google.com avec un compte Google.
- Allez sur aistudio.google.com/app/apikey.
- Cliquez sur Create API key, choisissez ou créez un projet Google Cloud et copiez la clé.
- Collez-la dans l'emplacement de fournisseur avec Provider réglé sur Google, puis utilisez Load models.
OpenRouter (une clé, les modèles de nombreux fournisseurs)
- Connectez-vous sur openrouter.ai.
- Allez sur openrouter.ai/keys.
- Cliquez sur Create Key, nommez-la et copiez la valeur.
- Collez-la dans l'emplacement de fournisseur avec Provider réglé sur OpenRouter, puis utilisez Load models.
DeepL (traduction automatique)
- Connectez-vous sur deepl.com/pro-api.
- Ouvrez Account → API keys et copiez votre Authentication Key.
- Collez-la dans l'emplacement Translation provider avec le traducteur réglé sur DeepL.
DeepL est facturé au caractère (environ 20 € par 1M de caractères), généralement moins cher qu'un LLM pour de la traduction pure. Vous pouvez aussi ignorer entièrement DeepL et traduire avec le même LLM que l'étape d'amélioration.
Load models — aucun id de modèle à saisir
Une fois la clé API en place, enregistrez la section et cliquez sur Load models sous le champ Model : le module appelle l'endpoint de liste des modèles du fournisseur avec votre clé et remplit une liste déroulante avec tous les modèles que votre clé peut réellement utiliser — choisissez dans la liste au lieu de saisir un id. Un champ texte manuel reste en secours pour un id de modèle absent de la liste. Un lien juste sous le champ pointe toujours vers la bonne page de clés du fournisseur actuellement sélectionné.
Estimer le coût d'une exécution sur tout le catalogue
Une passe complète a deux facteurs de coût qui s'additionnent par produit : amélioration (tokens LLM, facturés au million) et traduction (caractères, facturés au million, multipliés par le nombre de langues cibles). Utilisez le calculateur ci-dessous pour dimensionner une exécution avant de la lancer — c'est une estimation purement indicative ; vos chiffres réels dépendent de la longueur du contenu et des modèles que vous choisissez.
Full-catalog run cost calculator
Estimate what one full pass over your catalog costs. Two cost drivers add up per product: improve (LLM tokens, priced per million) and translate (characters, priced per million, multiplied by the number of target languages). Everything is billed to you directly by the AI/translation provider — this is a purely indicative estimate.
| Improve model | ~ improve / product | Full-catalog improve ~ |
|---|---|---|
| Gemini 2.x Flash | ~€0.0004 | ~€2 |
| OpenAI gpt-4o-mini | ~€0.0006 | ~€3 |
| Claude Haiku 4.5 | ~€0.004 | ~€20 |
| Claude Sonnet 4.5 | ~€0.015 | ~€75 |
Guide utilisateur
Profils et persona prompt
Tout ce que fait le module est organisé en profils. Un profil est une configuration réutilisable que vous exécutez sur une partie du catalogue : quels attributs il peut toucher, la pipeline d'étapes à appliquer, une éventuelle catégorie exclusive pour que le profil n'opère que sur les produits de cette catégorie, et un persona prompt — des instructions en texte libre qui définissent le ton de voix et les règles de la réécriture. Les profils sont anti-revert : un produit déjà traité par un profil est ignoré à l'exécution suivante sauf si vous le réinitialisez, donc réexécuter est sûr.
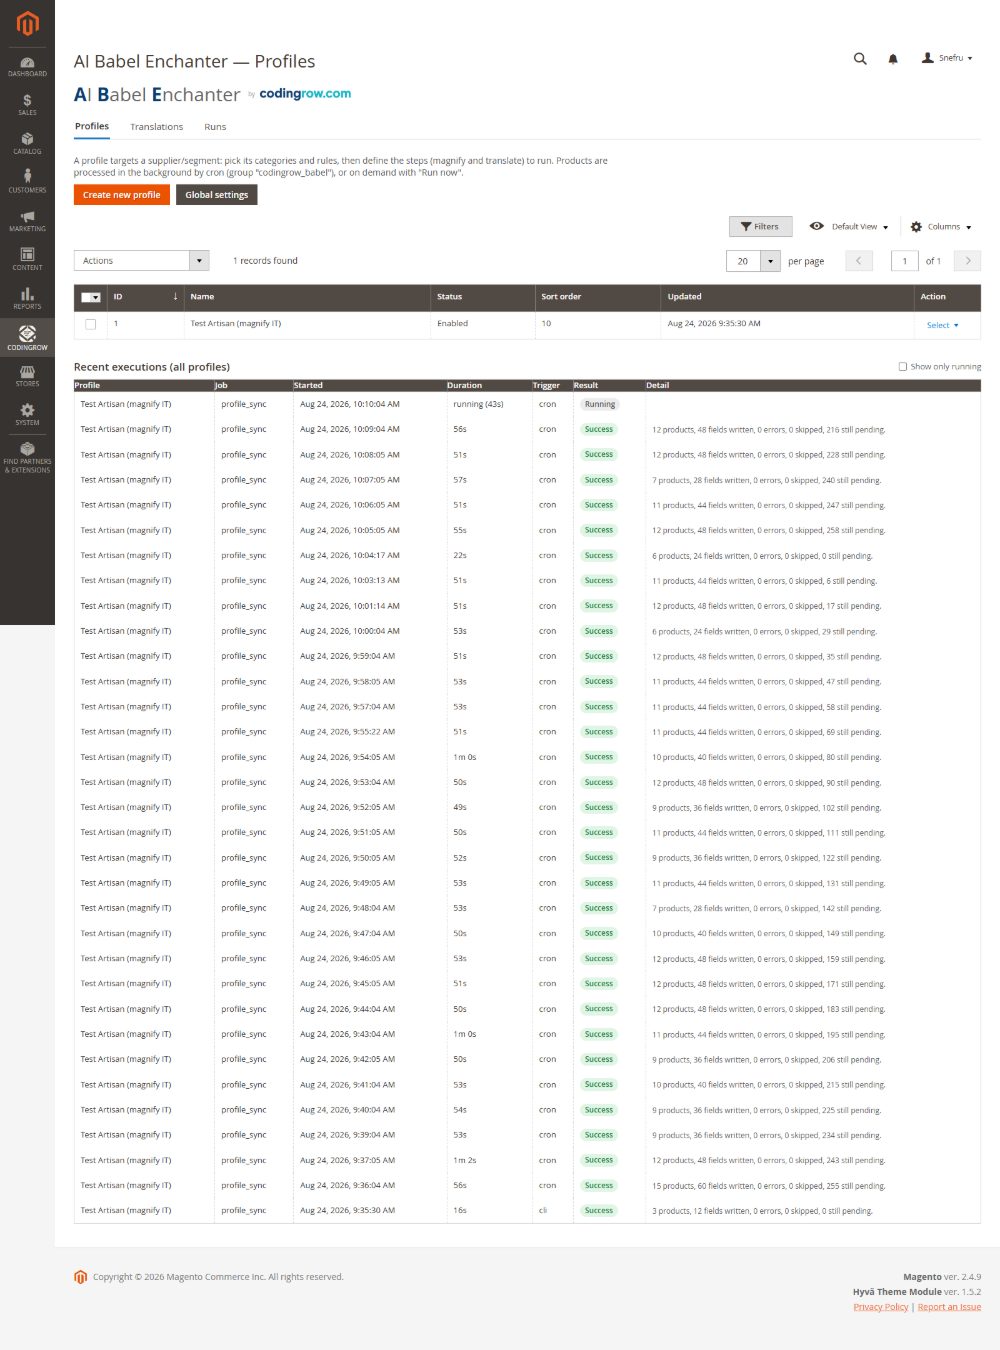
Groupes et étapes (la pipeline)
Au sein d'un profil, vous définissez des groupes d'étapes exécutées dans l'ordre. Les deux types d'étape principaux sont improve (réécrire/enrichir le texte source avec le fournisseur d'amélioration) et translate (produire les versions dans la langue cible). La pipeline normale est improve → translate : la langue source est réécrite d'abord, puis c'est le texte amélioré qui est traduit, de sorte que chaque store view hérite du meilleur contenu au lieu de traduire l'ancien texte. Le regroupement vous permet d'appliquer des étapes différentes à des attributs différents et de les exécuter en une seule opération.
AI — Models (le pool d'identifiants)
Enregistrez chaque IA une seule fois dans l'onglet AI — Models et réutilisez-la partout. Chaque ligne est un identifiant : un nom personnalisé, le fournisseur (Anthropic, OpenAI, Google/Gemini, OpenRouter ou DeepL), la clé API (stockée chiffrée), le modèle — saisissez-le ou cliquez sur Load models pour ne choisir que les modèles que votre clé peut réellement utiliser, chacun annoté de sa vitesse de réponse — une capacité (translate / enhancement / both), une valeur par défaut, un ordre de fallback et un indicateur d'activation.
Ajoutez-en autant que vous voulez : si une clé lâche (plus de crédit, rate limit, une erreur d'authentification), le module la marque en cooldown et bascule vers l'identifiant suivant de la chaîne, entre fournisseurs, de sorte qu'une longue exécution survit à une clé morte. Le modèle et le prompt sont ensuite choisis par étape dans le profil — enrichissez avec un modèle haut de gamme et traduisez les titres à faible valeur avec un modèle économique et rapide, dans une seule pipeline.
Max tokens (par identifiant) est le plafond des tokens qu'un modèle peut générer — une limite, pas un objectif, donc vous ne payez que ce qui est produit. Trop bas et le texte est tronqué ; avec les modèles de raisonnement, il peut même ne rien renvoyer. La valeur par défaut de 4000 couvre description + description courte + titre + méta. Extended thinking est désactivé par défaut (cela n'améliore pas les textes de vente) et vous pouvez définir un prix optionnel par IA qui alimente l'estimation de coût.
AI Compare
Ouvrez l'onglet AI Compare d'un profil, cochez les modèles à comparer et choisissez quelques produits d'exemple. Run comparison enrichit chaque échantillon avec chaque modèle (un dry-run — rien n'est écrit) en une matrice : une colonne par modèle, une ligne par produit, chaque cellule affichant le titre généré avec une référence, le temps de génération, un coût € indicatif (à partir des décomptes réels de tokens de l'API) et un Preview qui ouvre le résultat entièrement rendu.
Un juge — le modèle que vous choisissez dans la liste déroulante, idéalement le plus performant — note chaque sortie sur la qualité de langue, la mise en forme, les mesures contextualisées, le registre premium, la validité du JSON et le SEO, et désigne un gagnant ; le verdict ajoute le temps moyen et le coût moyen par modèle. Choisissez All models judge et chaque modèle renvoie son propre verdict, un tableau chacun. Un minuteur en direct et un skeleton montrent le juge au travail, un bouton Stop interrompt, et la dernière comparaison est enregistrée sur le profil pour qu'elle réapparaisse — avec un horodatage — sans réexécution.
Comment fonctionnent les tokens (et ce que provoque un mauvais réglage)
Chaque étape magnify ou translate est un appel à un modèle d'IA. Le modèle lit votre prompt de persona, les champs source du produit et — lorsqu'il génère aussi le titre — un petit échantillon de titres apparentés : c'est l'entrée. Il écrit ensuite un unique objet JSON avec les champs réécrits : c'est la sortie. Le fournisseur vous facture les deux, mais les tokens de sortie coûtent plusieurs fois plus que ceux d'entrée, donc c'est la longueur du texte généré qui détermine le coût.
Max tokens ne plafonne que la sortie qu'un modèle peut produire en un appel. C'est une limite, pas un objectif : si le texte se termine naturellement plus tôt, vous ne payez que ce qui a été écrit, donc un plafond généreux ne coûte jamais plus — il empêche seulement qu'une bonne sortie soit coupée. La valeur par défaut de 4000 couvre aisément une description riche plus short description, titre et meta description réunis.
Ce que provoque un plafond trop bas. Si la sortie devait être plus longue que le plafond, la réponse est tronquée en milieu de phrase et le JSON ne se ferme jamais — le module ne peut pas l'analyser. Certains modèles récents effectuent aussi un raisonnement caché avant d'écrire : avec un plafond serré, ils peuvent dépenser tout le budget à réfléchir et ne renvoyer absolument rien. Dans les deux cas, Babel ne conserve pas silencieusement le texte original — il marque ce produit comme échoué avec la vraie raison dans la file, afin que vous puissiez relever le plafond et réessayer. Si des produits reviennent anormalement courts ou “bloqués dans la langue source”, le plafond de tokens est la première chose à vérifier.
Extended thinking est désactivé par défaut, à dessein. Pour les textes de vente du catalogue, il n'améliore pas le résultat — le même texte sort — tout en consommant tokens et temps et en risquant le piège de la réponse vide ci-dessus. Laissez-le désactivé pour la génération ; le juge AI Compare l'active uniquement là où le raisonnement aide vraiment, et se rabat élégamment lorsque le modèle choisi ne le prend pas en charge.
En pratique : gardez Max tokens à 4000 (ou un peu plus pour les descriptions très longues), surveillez la file pour repérer les échecs avec une raison claire plutôt qu'une mauvaise sortie silencieuse, et laissez l'estimation de coût — alimentée par les décomptes réels de tokens que renvoie l'API — vous indiquer ce que chaque exécution coûtera réellement avant de la lancer.
Les caractéristiques objectives du produit
Dans beaucoup de catalogues, les mesures ne sont dans aucun attribut : elles sont dans le nom. Rouleau de Papier Peint 10 m, Rallonge Électrique 5 m. Une personne lit cela sans peine, la boutique non : qui demande dix mètres se voit proposer une fiche à une pièce, parce qu’aucun champ ne dit quelle longueur fait une pièce.
Pendant qu’il travaille un article, Babel note ses données mesurables dans l’attribut Product characteristics (Babel) de la fiche produit, que tu lis et corriges.
unita_vendita: confezione
copertura_pezzo: 2.22 m2
pezzi_confezione: 8
spessore: 8 mm
materiale: stratifié
tipologia: sol flottant (dedotto)
unita_vendita n’est jamais déduite. C’est un terme commercial : elle dit à quoi se rapporte le prix. Une ligne autre que pezzo n’est écrite que si les trois conditions sont réunies — elle n’est pas déduite, le nombre qui rend le calcul possible est là (pezzi_confezione pour le paquet, copertura_pezzo pour les mètres), et la preuve est dans les données du produit, vérifiée par le module et non crue sur parole de l’IA. Si rien ne le dit, la ligne est simplement absente, et cela signifie que le prix est celui d’une pièce : le côté sûr.
Le calcul est fait par copertura_pezzo — ce que couvre UNE pièce — qui est une mesure et s’établit à partir du produit. Un paquet de stratifié qui couvre 2,22 m² porte unita_vendita: confezione et copertura_pezzo: 2.22 m2, et une demande de trente mètres carrés devient quatorze paquets. Sans la paire, c’était trente paquets : plus du double de la dépense.
Le marqueur (dedotto) est la frontière. Une ligne qui se termine ainsi n’a été écrite par personne : l’IA l’a déduite. Elle aide à comprendre et à chercher, mais on n’en tire jamais une quantité. Pour confirmer une donnée, on efface ce mot ; ce qui est faux, on le corrige, ce qui n’a rien à y faire, on l’enlève. C’est ton catalogue.
Sur un produit à variantes, chacun porte sa part : le parent ce qui vaut pour toutes (l’unité de vente, la matière, le type), chaque variante ce qui la distingue (sa mesure, son diamètre). Les variantes ne sont traitées que lorsque ce qui change est une mesure : si seule la couleur change, la variante n’aurait rien de propre à dire. Un produit groupé ou un bundle n’a pas de mesures propres — c’est une liste d’articles, chacun avec les siennes — et sur les produits virtuels et téléchargeables on n’écrit rien : un cours ne se mesure pas.
Il ne réécrit pas tes textes : c’est un appel à part, petit, avec sa propre mémoire. Pour les articles déjà traités, il y a le bouton Noter les caractéristiques sur la page du profil, ou bin/magento babel:params --profile=3. Sur un catalogue réel : 38 articles parents et 116 variantes passés en revue, l’unité de vente sur 34 des 38 parents — elle appartient au parent et jamais à la variante, car la façon dont une chose se vend ne change pas entre le 80 et le 100.
Sur une variante le champ est souvent vide, et c’est le bon résultat : ce qui la distingue est déjà dans un attribut Magento (son poids, la mesure sur laquelle elle varie), et l’écrire aussi ici ferait deux copies destinées à diverger — la variante l’emportant sur le parent. Sur ce catalogue, 97 des 116 variantes portent une ligne propre, les 19 autres n’avaient rien à ajouter. Et les règles valent aussi sur ce qui est déjà écrit : une ligne laissée par une version antérieure qui enfreint le format d’aujourd’hui est retirée au passage suivant, tandis qu’une ligne que tu as corrigée à la main n’est jamais touchée.
Types de produit et traitement différencié
Un produit configurable n'est pas un article unique, un groupé n'est pas un colis, et un produit virtuel ou téléchargeable ne s'expédie pas. Le module reconnaît le type tout seul et remet à l'IA une description de la structure, qui change ce que le texte dit et ce qu'il ne doit pas dire.
Où l'activer. Onglet Mapping du profil, sur l'étape concernée : Contexte de structure du produit. Désactivé par défaut : l'activer change ce que l'IA reçoit et régénère donc les fiches de ce profil à la passe suivante. Activez-le avant une nouvelle passe, pas au milieu d'une passe en cours.
- Configurable — reçoit l'axe de choix avec son libellé dans la langue de la boutique (par exemple taille : 80, 100), les options et les attributs qui diffèrent réellement entre les enfants, établis par comparaison. Il n'y a rien à configurer à la main : les attributs d'un configurable, le module les relève seul. Prix, prix spéciaux, coûts et paliers restent dehors à dessein, parce qu'ils changent et qu'un texte qui les cite vieillit mal. Le texte obtenu décrit la gamme ; un titre ne doit jamais porter la valeur d'une seule option (par exemple Tuyau 1m 100 quand 100 est l'une des tailles).
- Lot — reçoit les titres des options, lesquelles sont obligatoires et les articles sélectionnables dans chacune, pour que le texte puisse expliquer la composition du produit.
- Groupé — reçoit la liste des articles associés, pour que le texte dise qu'ils s'achètent ensemble et à quoi sert chacun.
- Virtuel — ne reçoit que le type, et cela suffit : il est interdit à l'IA de mentionner expédition, livraison, emballage et poids. Sans cette règle, le modèle écrit expédition rapide même pour une extension de garantie.
- Téléchargeable — reçoit le nombre de fichiers et l'existence d'un échantillon : le texte explique la livraison numérique, et l'expédition reste interdite.
Les variantes ne sont pas traitées. À côté se trouve Ignorer les variantes, activé par défaut au niveau du groupe : un produit qui apparaît comme enfant d'un configurable reste hors de la file. Il n'a pas de page que le client puisse ouvrir, donc l'enrichir est une dépense sans retour ; dans un catalogue bâti sur les variantes, elles forment l'essentiel de la file. Qui vend ses variantes comme des articles à part entière le désactive.
Restreindre les cibles. Sur la même étape, Types de produit et Visibilité limitent la file à ce que vous voulez vraiment traiter — par exemple seulement les configurables, ou seulement les produits visibles en catalogue et en recherche.
Cross-sell, associés et up-sell (relations IA)
Trois interrupteurs indépendants permettent à un profil de proposer des produits cross-sell, associés et up-sell à l'aide de l'IA. Le modèle ne suggère jamais que des SKU réels de votre catalogue — il ne peut pas inventer un produit inexistant — et les suggestions sont écrites dans les liens natifs cross-sell/associés/up-sell de Magento, de sorte qu'elles apparaissent dans les blocs standard du storefront. N'activez que les types de relation que vous voulez confier au module.
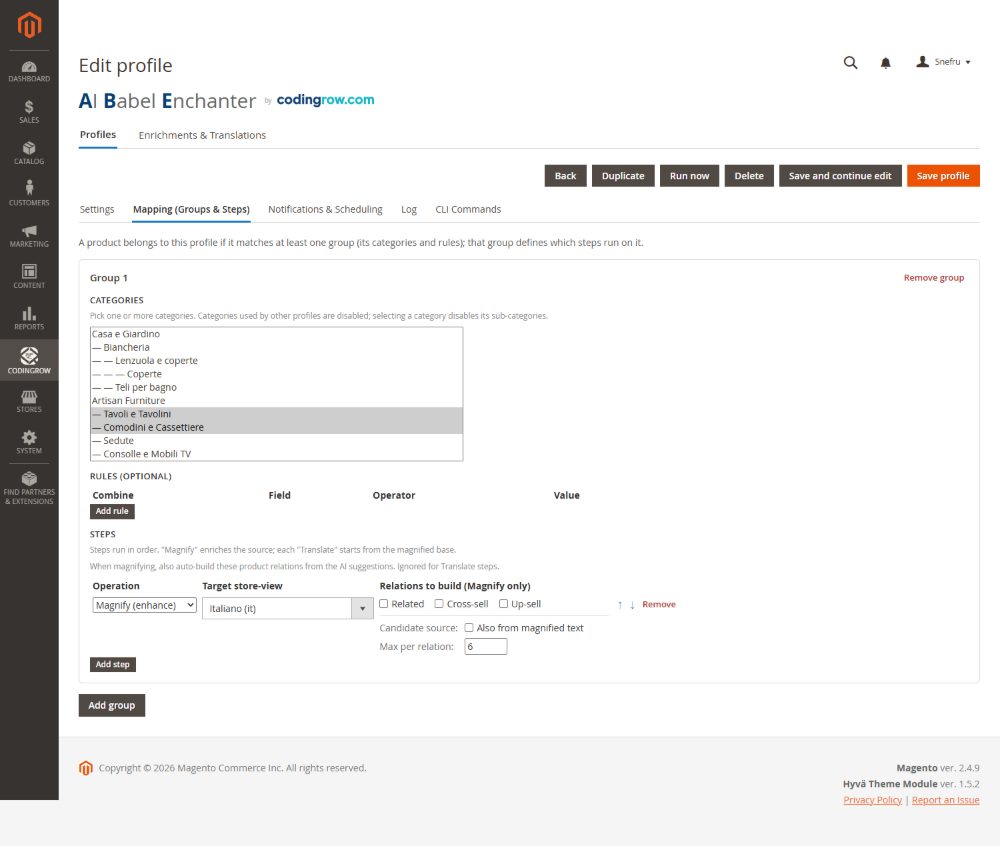
Aperçu en dry-run (et rendu)
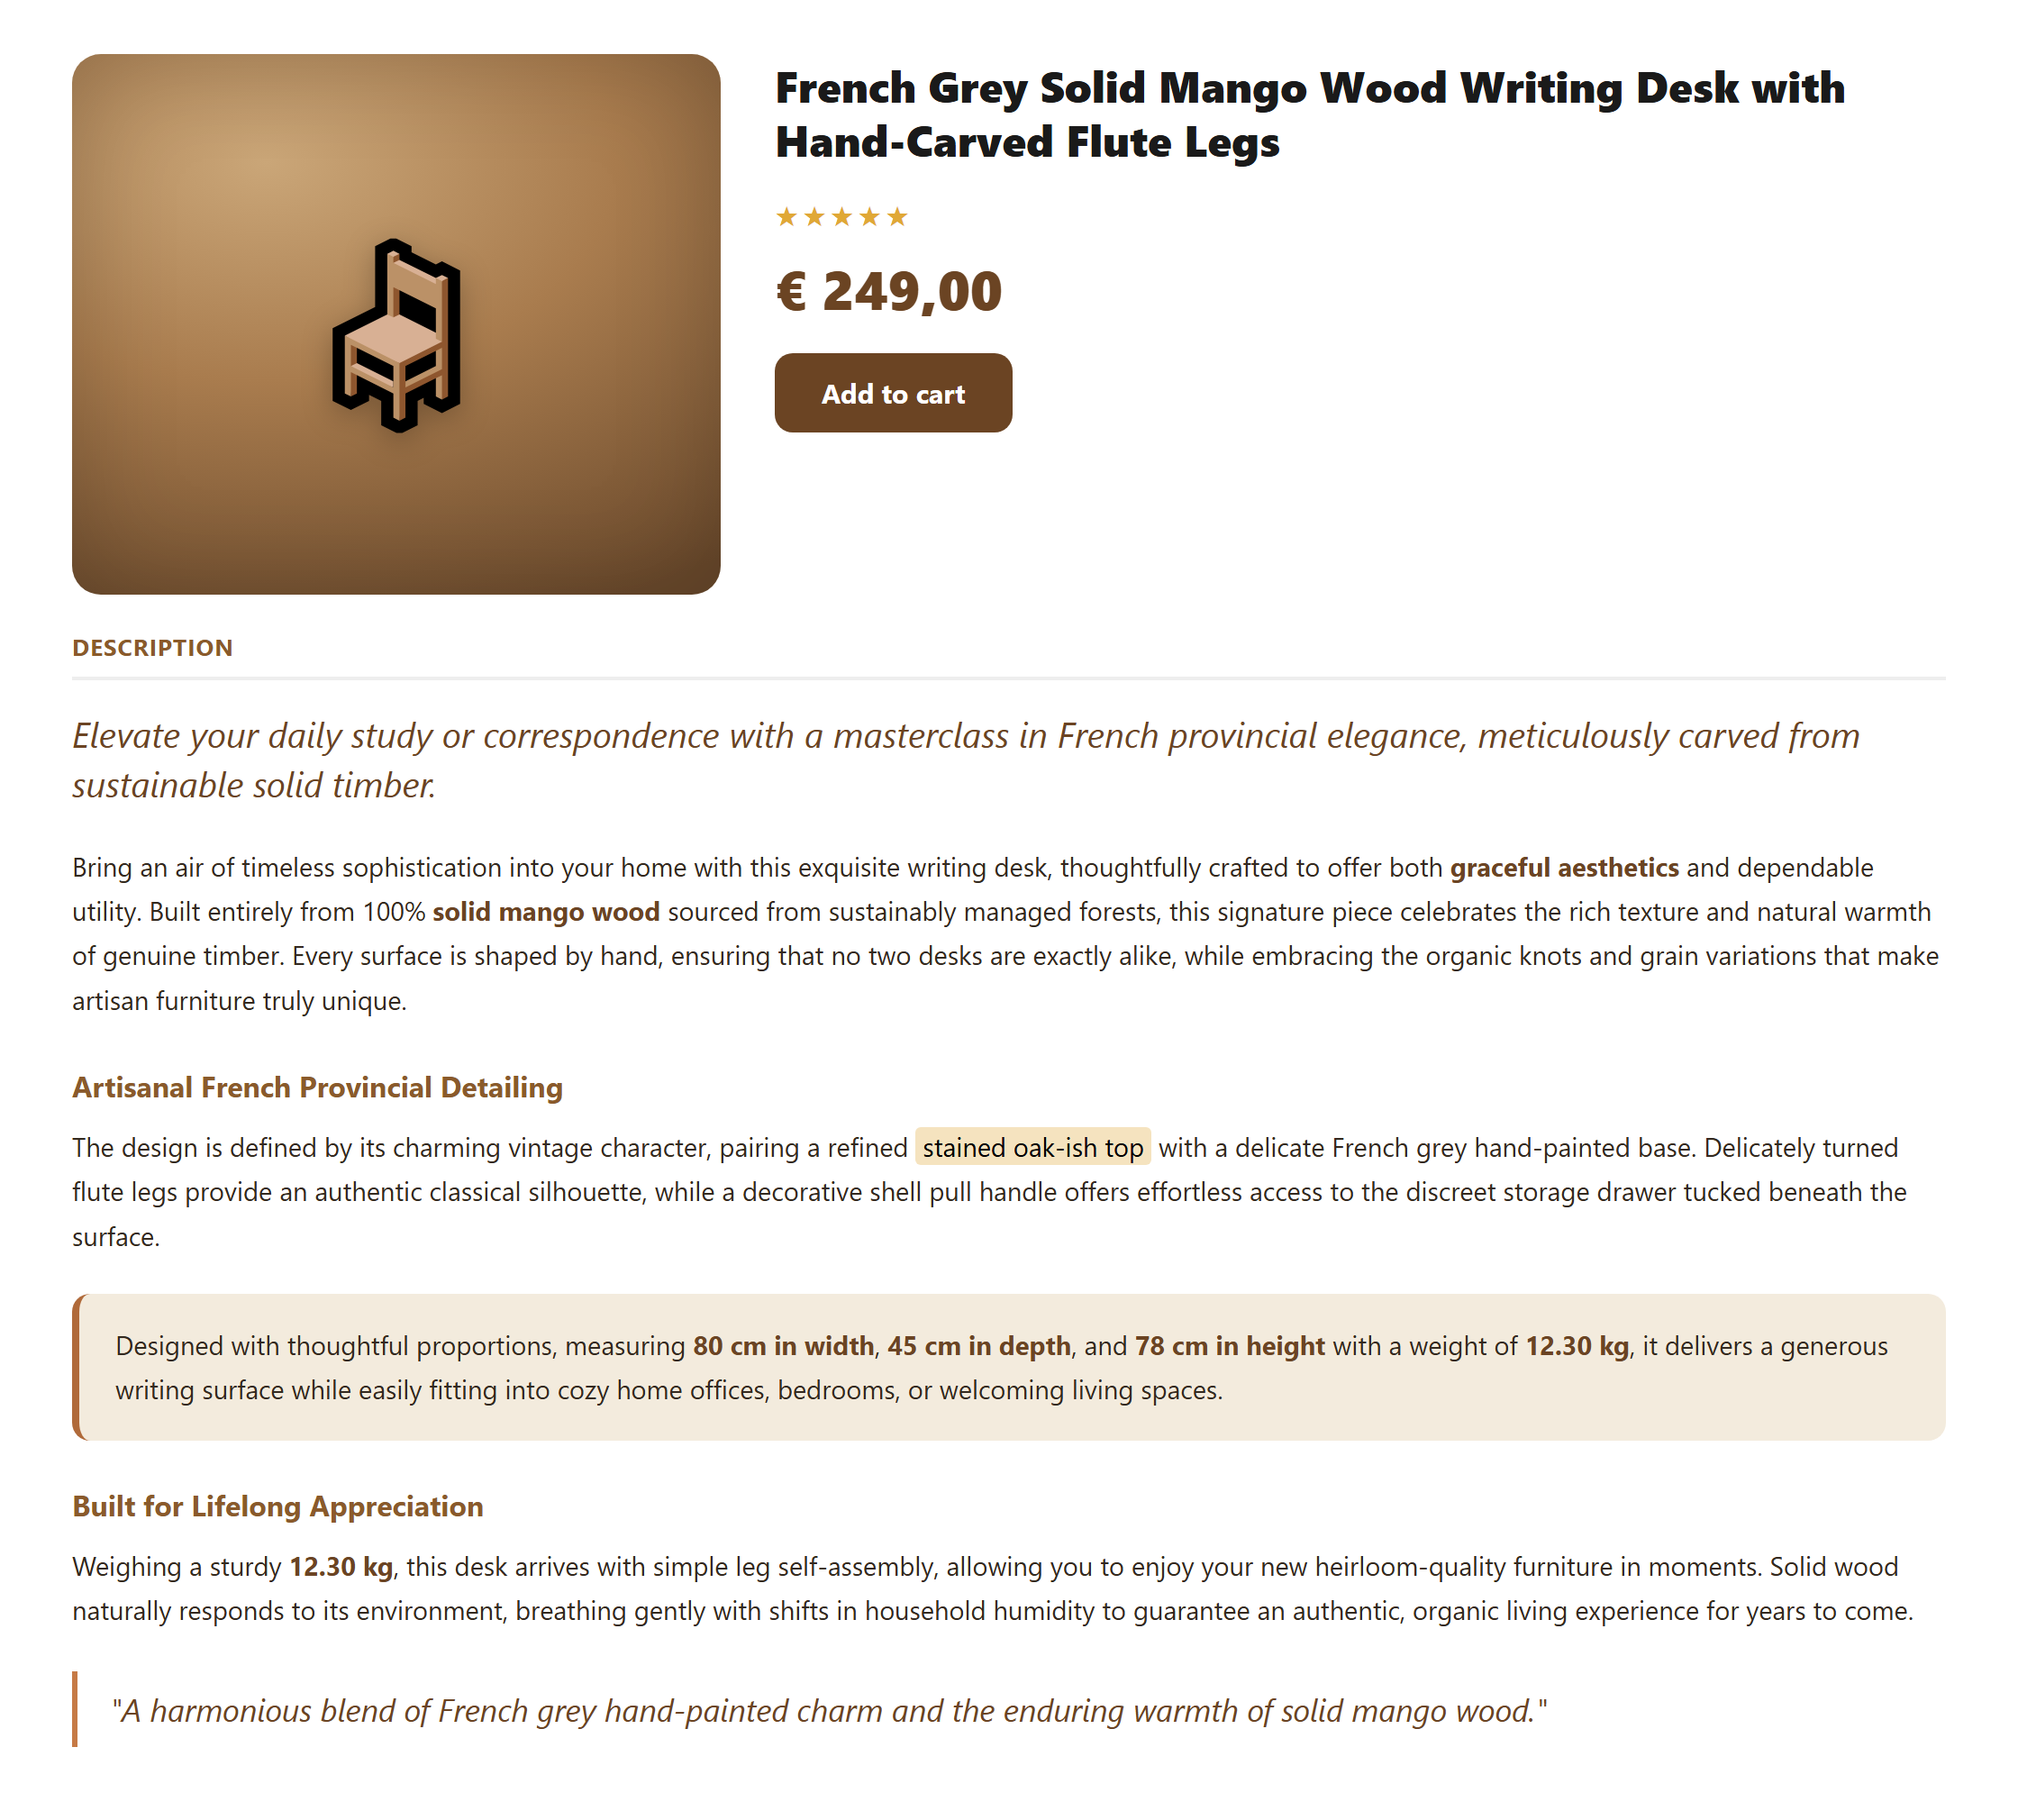
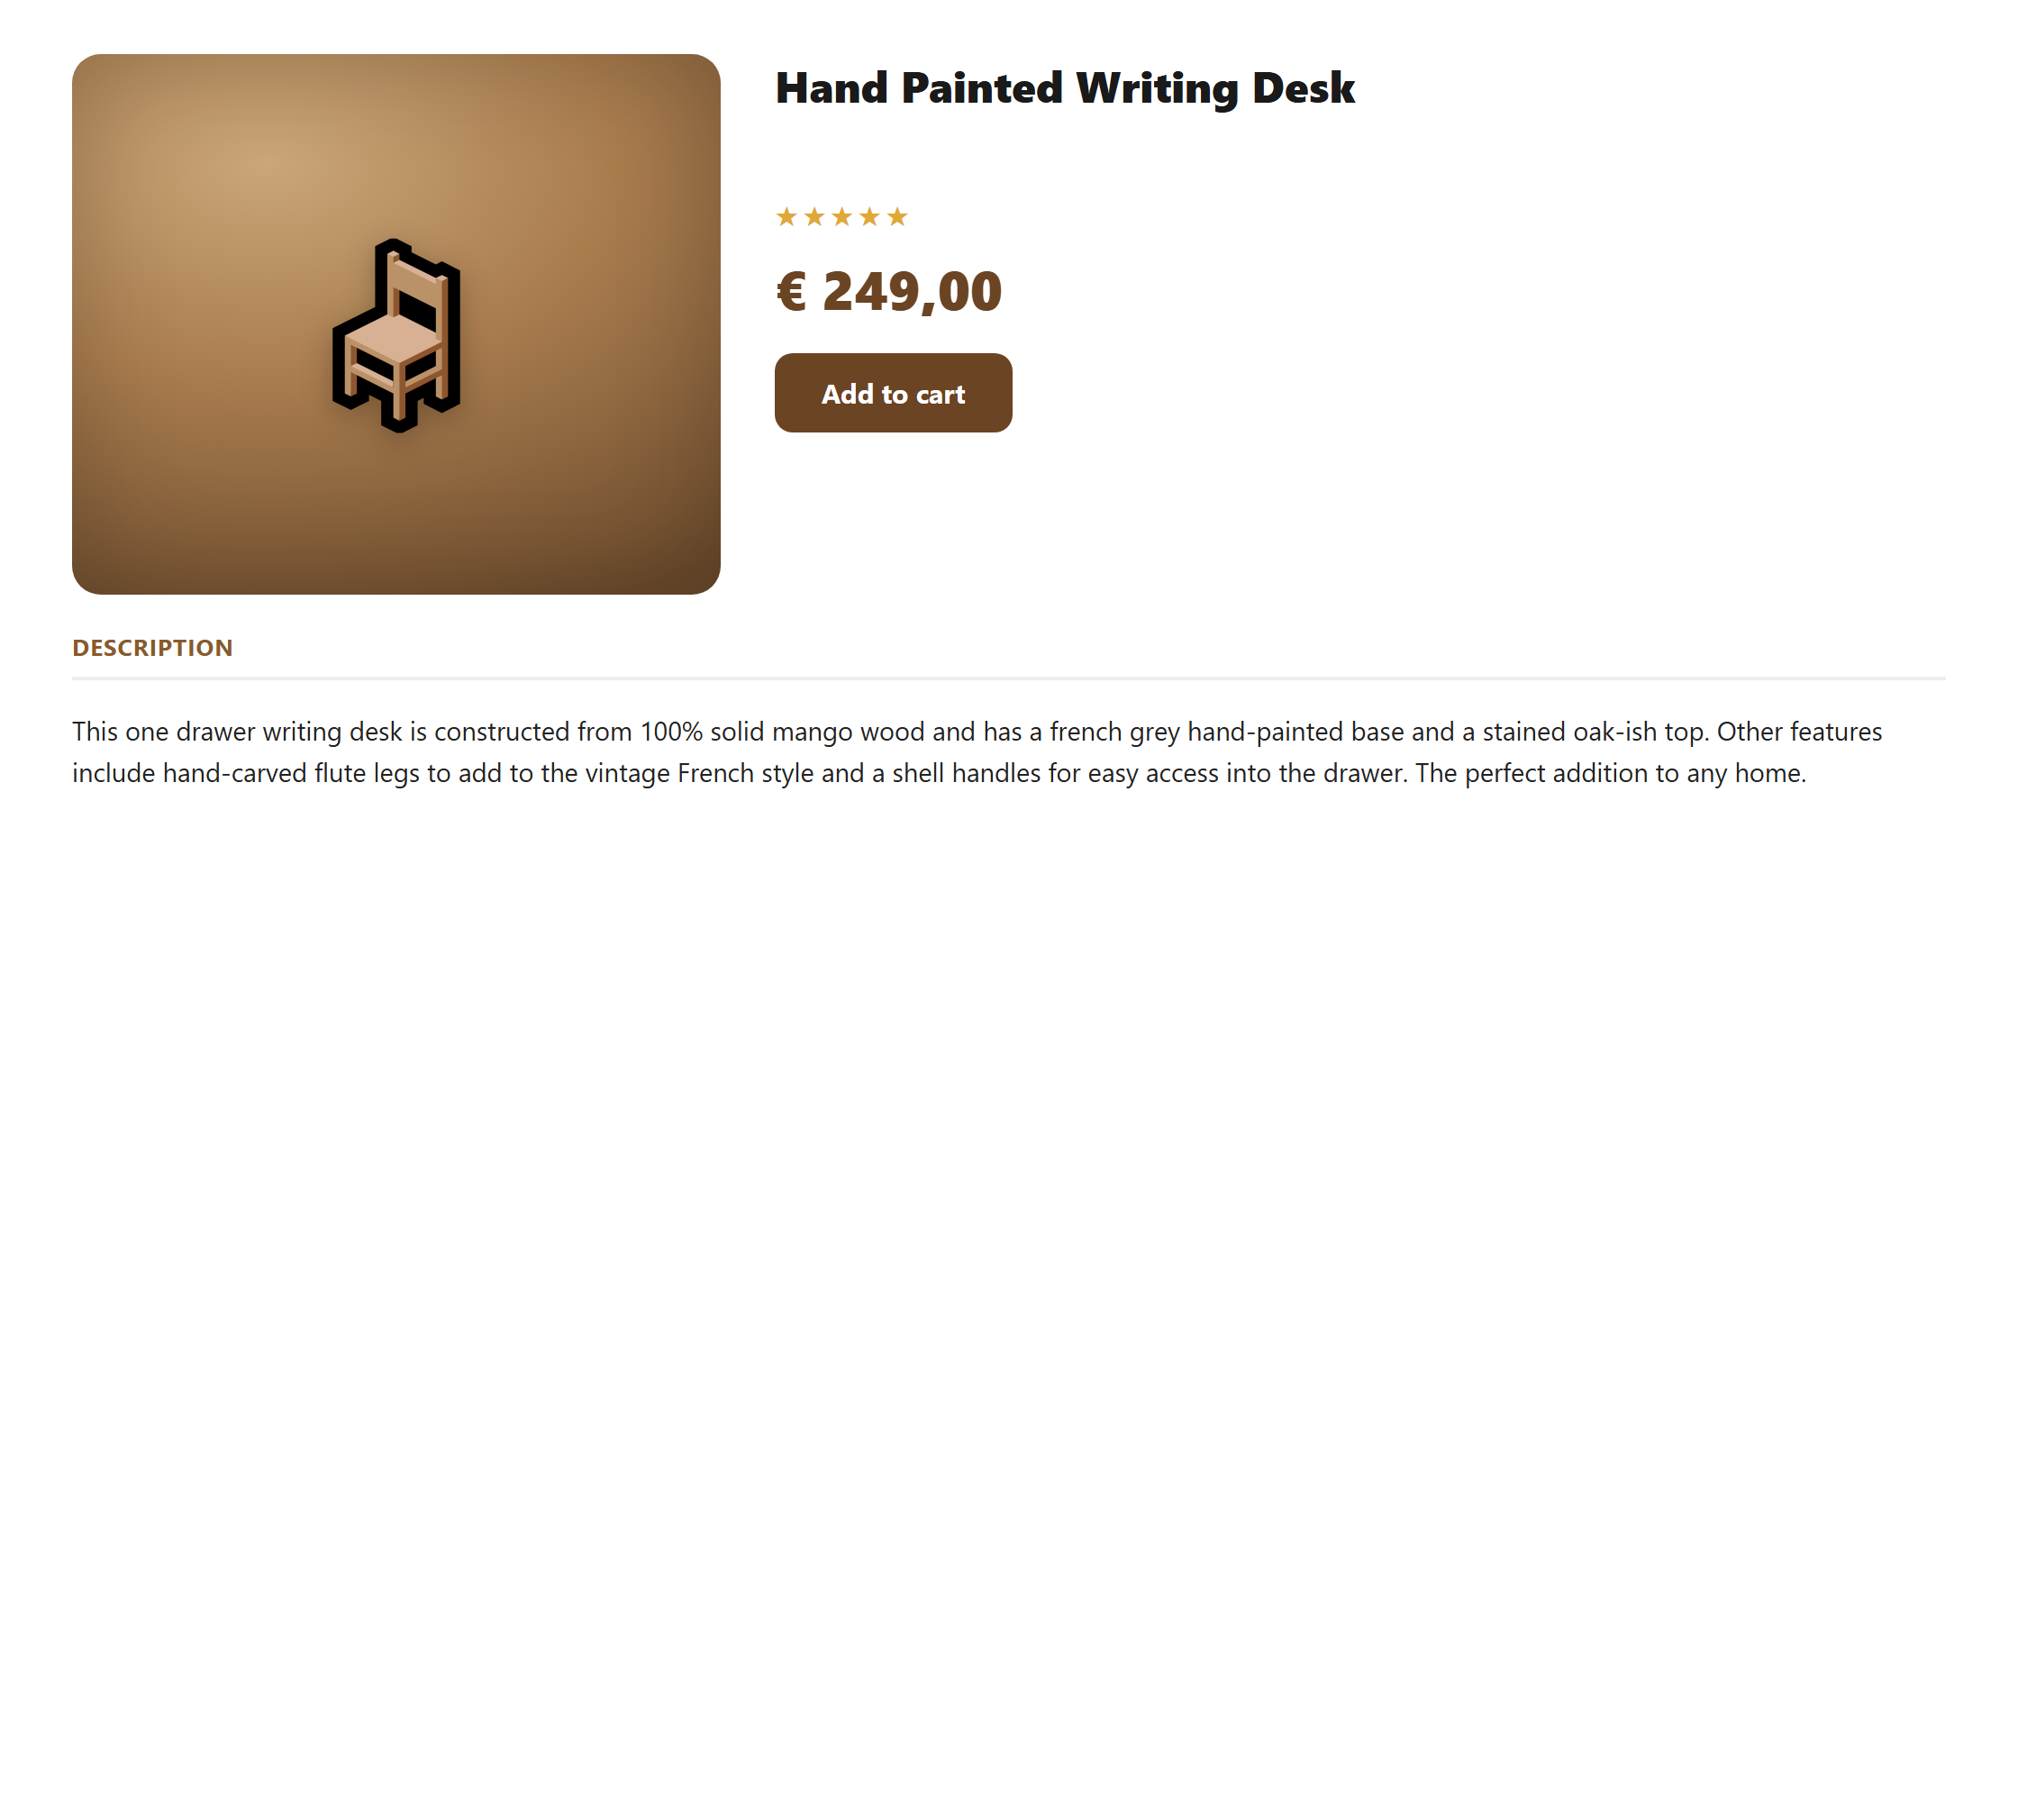
Avant que quoi que ce soit ne soit écrit, exécutez un profil en dry-run : le module génère le contenu proposé pour un échantillon de produits et l'affiche à côté du texte actuel, y compris un aperçu rendu pour que vous voyiez à quoi ressemblera vraiment la description améliorée sur la page — pas seulement le texte brut. En dry-run, rien n'est enregistré ; cela sert à valider le persona prompt et la pipeline avant de vous engager dans une exécution complète.
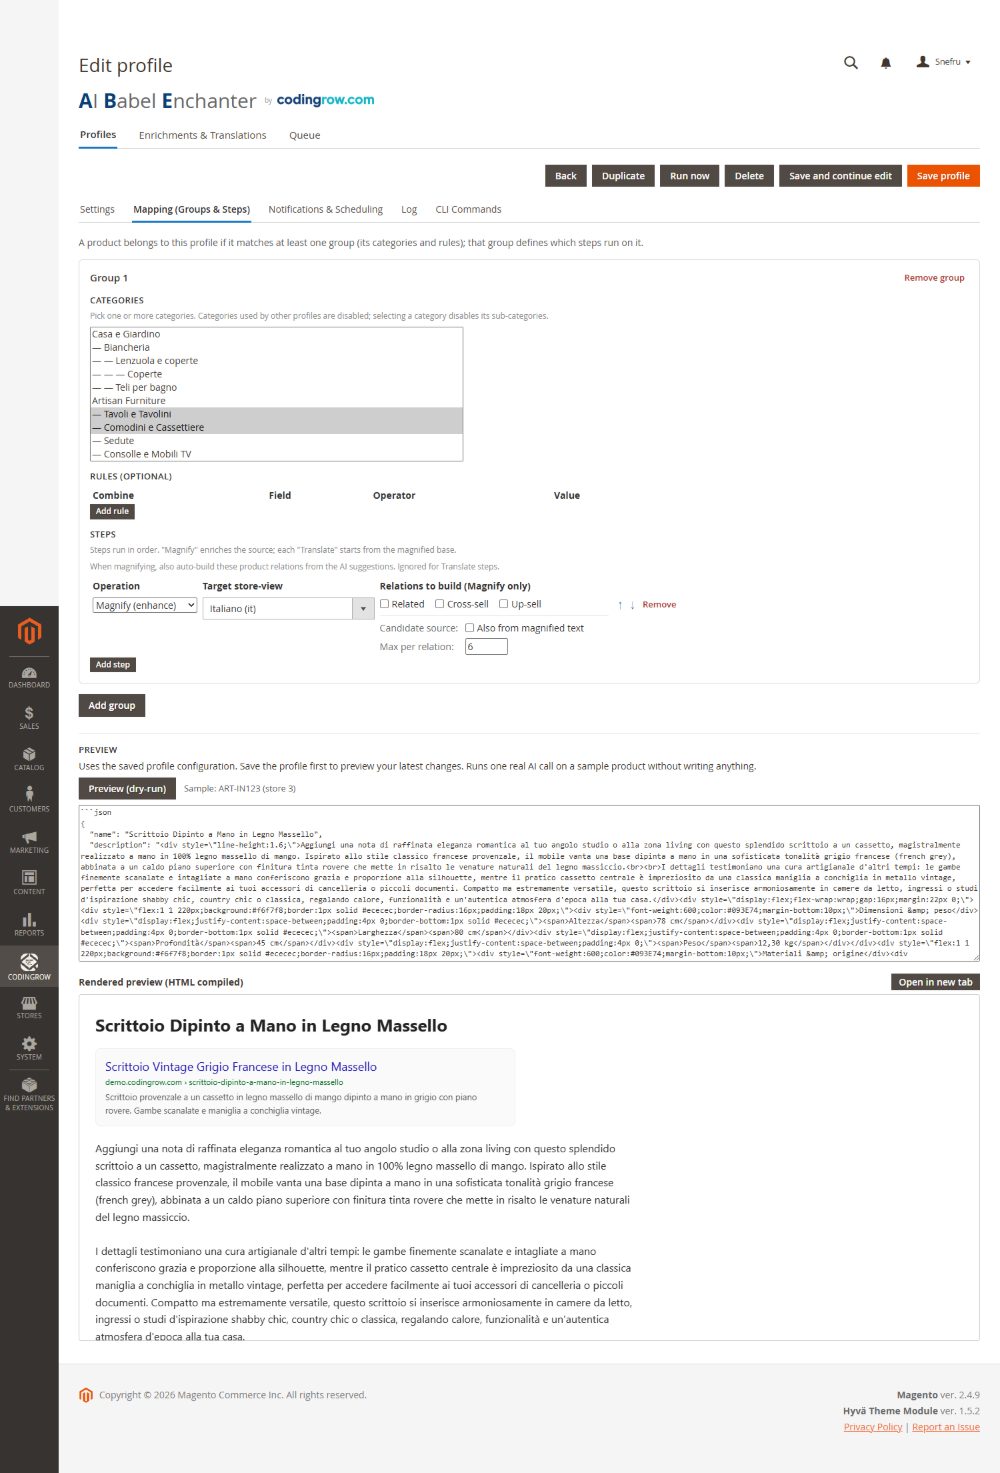
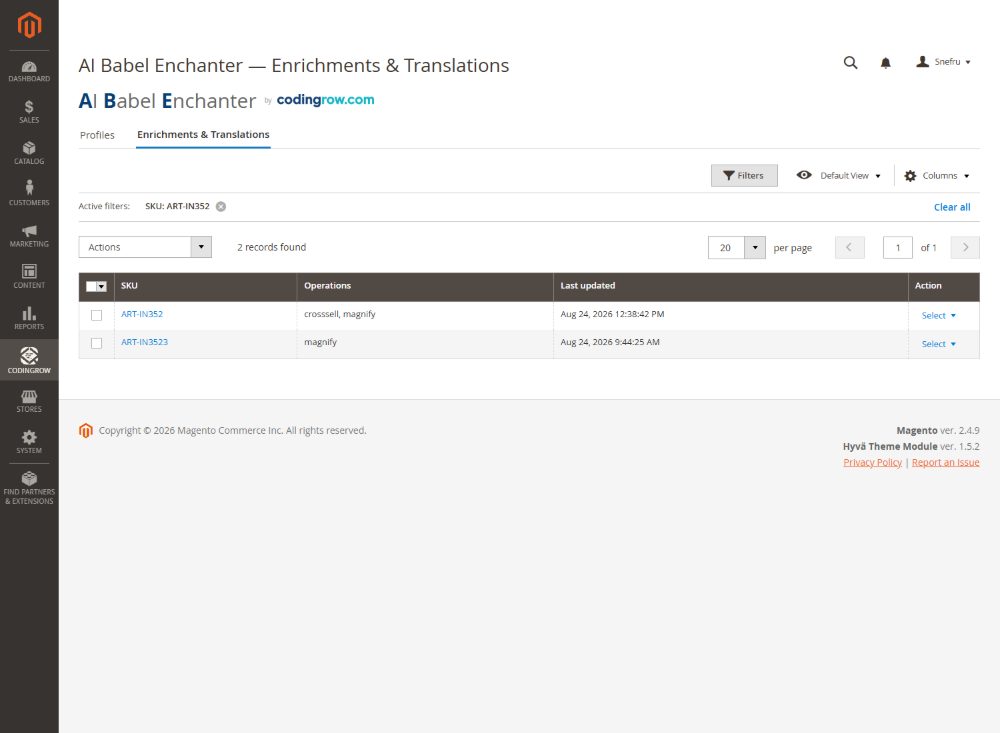
La grille "Enrichments & Translations"
L'onglet "Enrichments & Translations" est la grille de travail : chaque champ généré pour chaque produit et langue, paginée et filtrable. Vous pouvez modifier inline n'importe quelle valeur générée avant ou après son application — la sortie de l'IA est un point de départ, pas un verrou — et chaque ligne conserve un lien vers le texte original, de sorte que vous pouvez restaurer l'original de ce champ en une action si le résultat ne vous plaît pas. C'est la couche human-in-the-loop au-dessus de la pipeline automatisée.
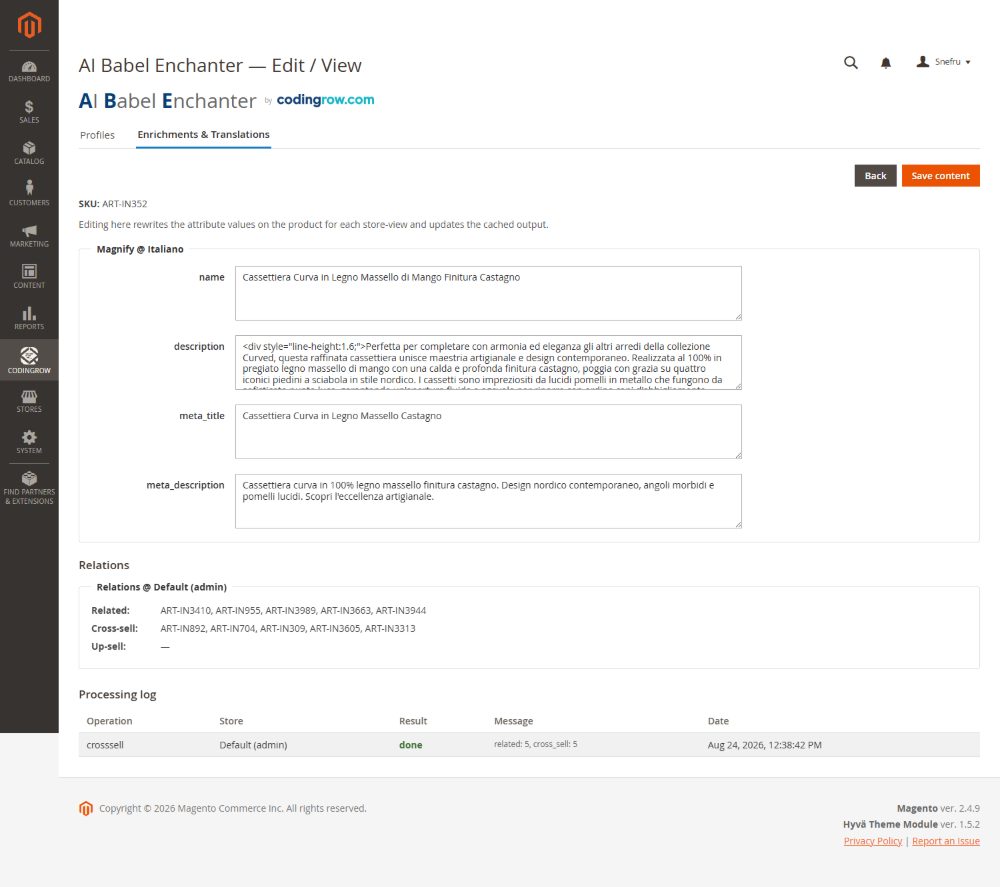
Les textes que vous déclarez définitifs
Tôt ou tard, il y a un produit dont vous rédigez vous-même la description : le produit phare, celui auquel le patron tient, celui dont le texte de l'IA était bon mais pas juste. Vous le corrigez à la main et, à partir de cet instant, vous voulez une garantie — que plus personne ne réécrive ce texte. Cette garantie, c'est la case Final, nouveauté de la v3.4.0.
Ouvrez Enrichments & Translations, ouvrez un produit : sous chaque champ se trouve une case à cocher intitulée « Final — never regenerate this text ». Cochez-la et ce champ-là vous appartient.
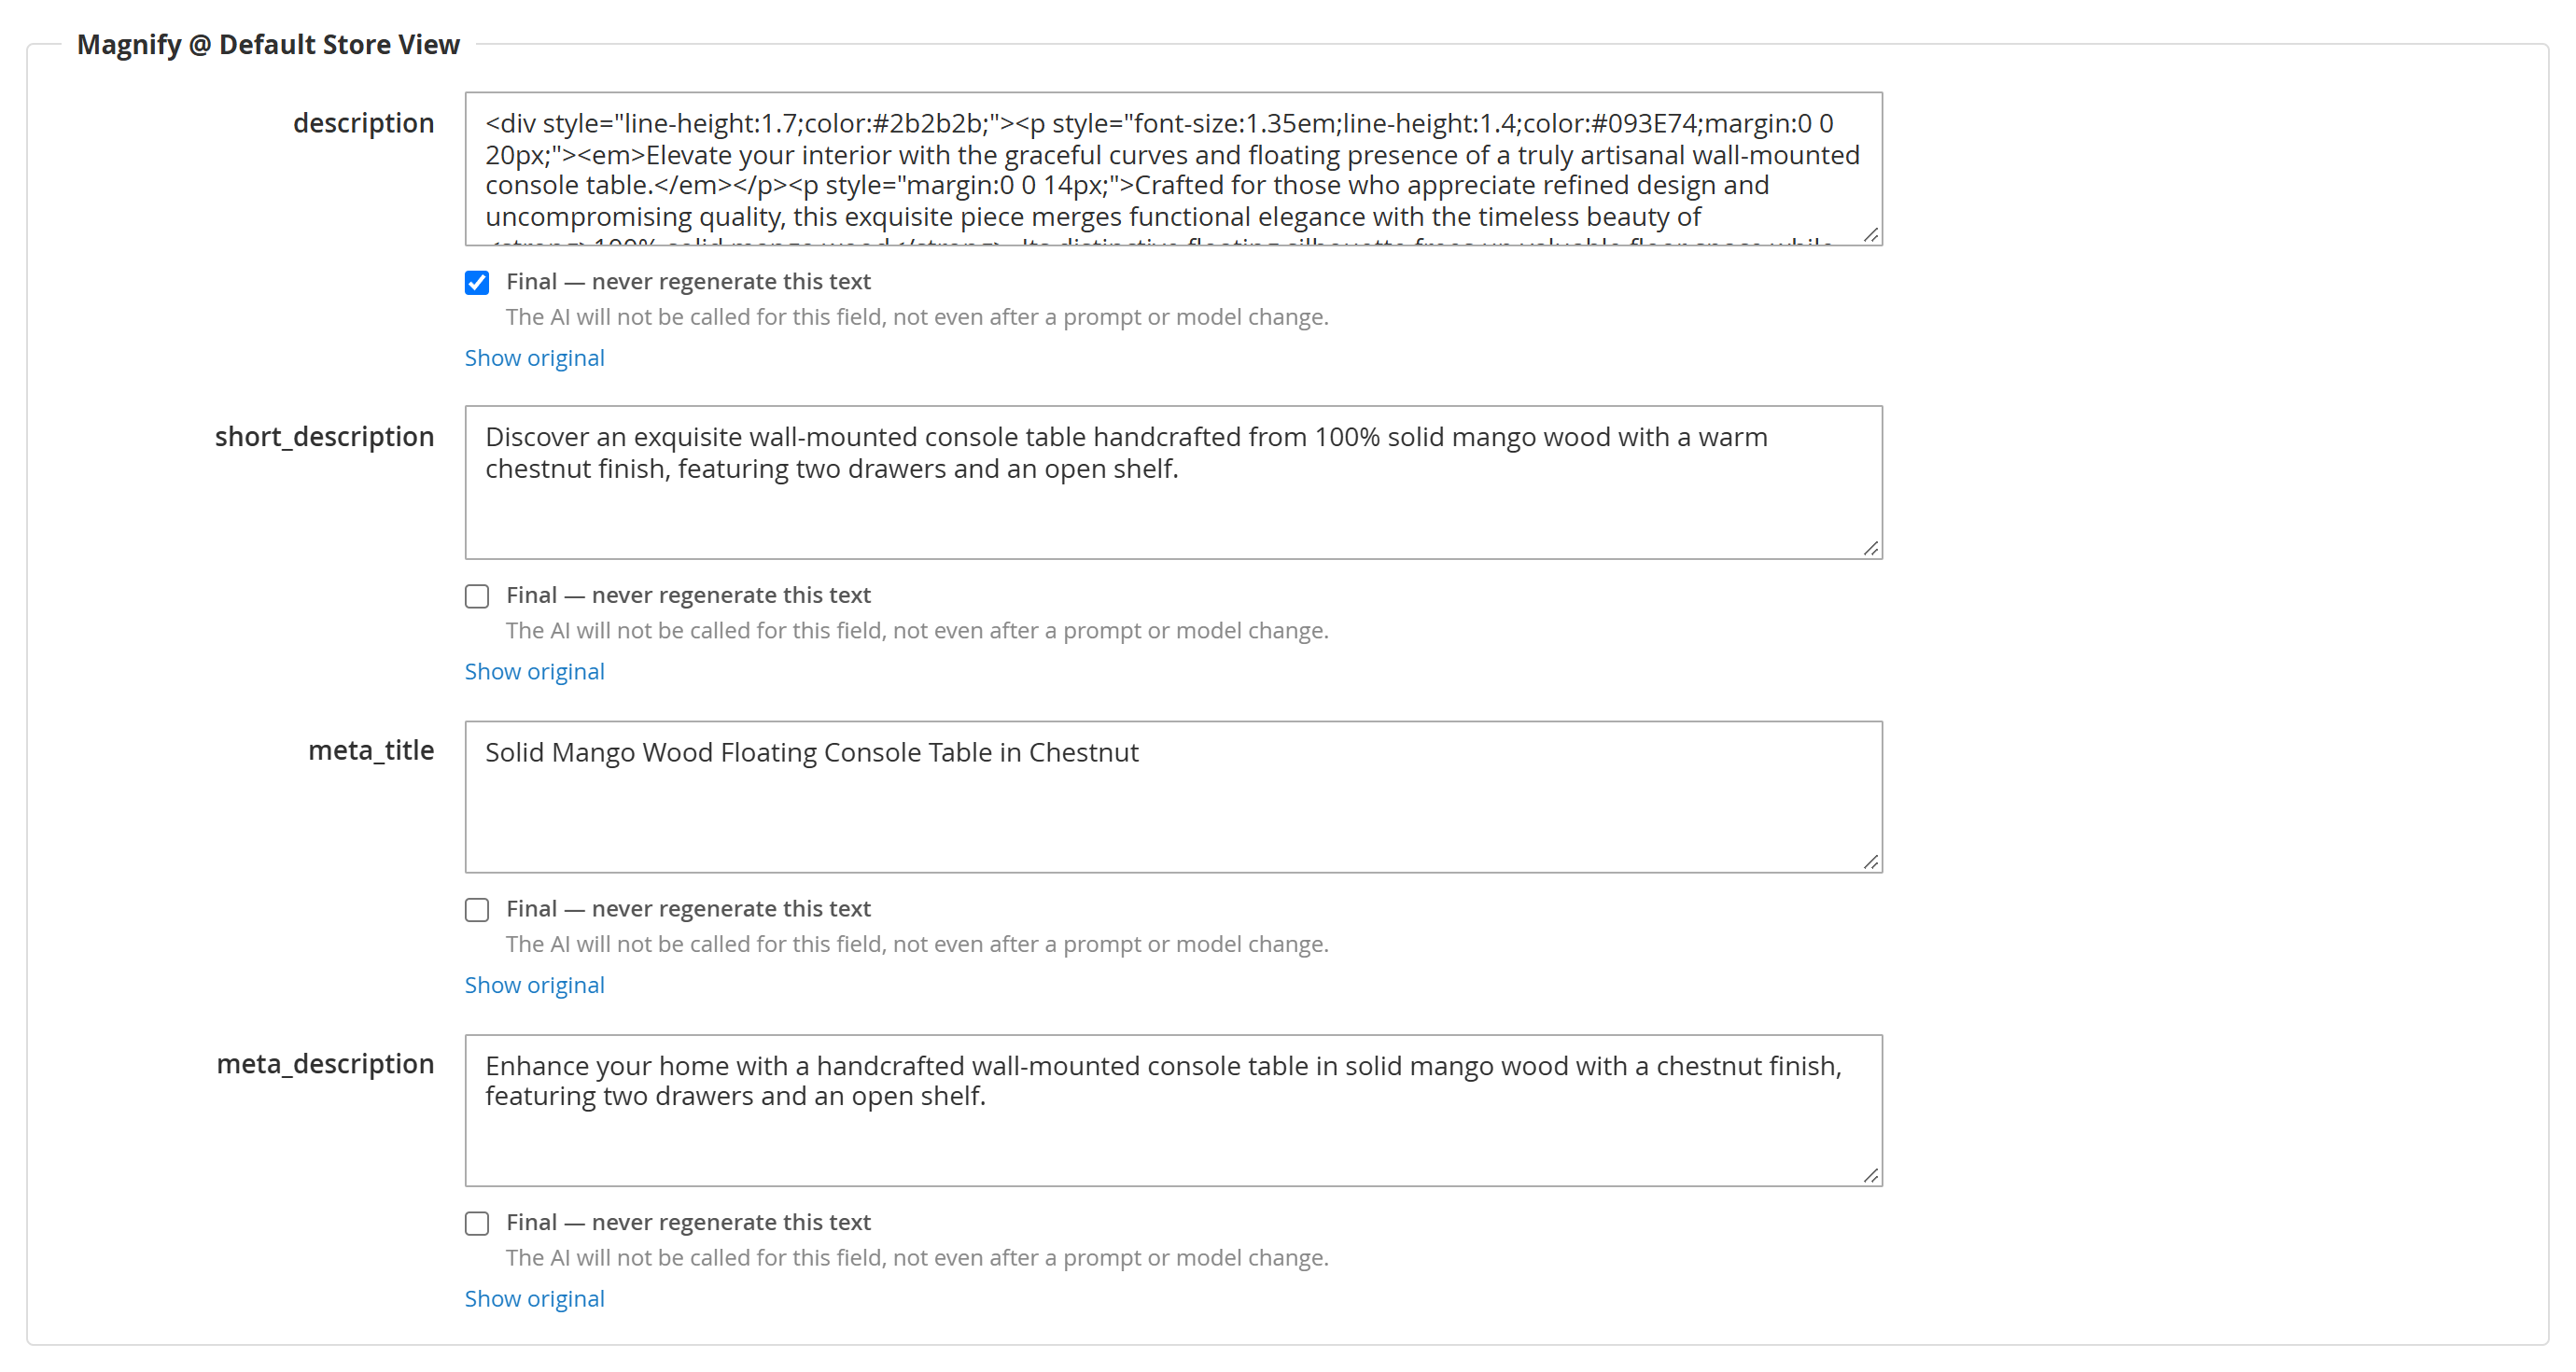
Ce que « final » signifie, précisément. Pour ce champ, sur ce produit, dans cette vue magasin :
- l'IA n'est plus jamais appelée pour lui — ni à la prochaine exécution, ni après une modification du prompt de persona, ni après un changement de modèle, ni après un vidage de cache, ni quand vous appuyez sur Apply to already processed. Cela ne coûte rien, à jamais. Et si tous les champs d'un produit sont déclarés finaux, l'appel à l'IA pour ce produit n'est pas effectué du tout ;
- si la valeur disparaît du produit — un importateur l'a écrasée, quelqu'un a restauré l'original, une migration l'a effacée — le contrôle en arrière-plan remet votre texte déclaré en place, là encore sans le moindre coût ;
- il l'emporte sur les règles automatiques du module lui-même. Le meta title, par exemple, est normalement forcé de suivre le nom du produit, toujours ; déclarez le meta title final et c'est votre texte qui l'emporte, même sur cette règle ;
- cela ne vaut que pour ce champ-là. Les autres champs du même produit continuent d'être générés normalement. Déclarer la description définitive ne fige pas le meta title, et ne retire pas le produit du profil.
Modifier dans la grille coche la case à votre place. Dès que vous saisissez du texte dans un champ de la grille, sa case Final se coche d'elle-même. C'est le comportement que l'interface laisse entendre — vous êtes allé corriger ce texte, la correction est donc tout l'enjeu — et avant la v3.4.0 cela ne se produisait pas : un texte corrigé à la main survivait jusqu'au prochain changement de prompt, puis était silencieusement régénéré par-dessus. Si vous souhaitez qu'un texte corrigé soit régénéré plus tard, décochez la case avant d'enregistrer.
La seule chose à retenir : un champ final est la seule chose, dans le module, qui survive à un changement de prompt de persona ou de modèle. Tout le reste est reconstruit à partir du résultat enregistré, et ce résultat est classé sous une clé qui inclut l'intégralité du prompt — changez le prompt et plus aucun résultat enregistré n'est réutilisable.
Les textes qui reviennent d'eux-mêmes
Voici une défaillance qui passait jusqu'ici inaperçue. Un produit déjà traité ne revient jamais de lui-même dans la file — c'est volontaire, pour qu'une nouvelle exécution du profil soit économique et sans risque. L'effet de bord : si quelque chose écrase un texte généré après le traitement du produit, ce produit n'est plus jamais examiné. La boutique continue d'afficher le texte écrasé, la file indique done, l'historique contient toujours le texte généré, et aucune erreur n'est signalée nulle part. Nous l'avons constaté sur un catalogue réel : 318 produits affichant des titres et des descriptions en anglais dans une boutique italienne, pendant des semaines, alors que le texte italien se trouvait toujours dans l'historique du module lui-même.
La v3.4.0 met fin à cela. Un contrôle en arrière-plan s'exécute toutes les heures et pose une seule question par résultat enregistré, en lisant uniquement la base de données et sans jamais appeler une IA pour la poser : le texte que j'ai écrit est-il toujours sur le produit ? Quand la réponse est non, le produit retourne dans la file avec le traitement le moins coûteux qui convienne :
| Ce que le contrôle trouve sur un produit | Ce qu'il fait | Ce que cela coûte |
|---|---|---|
| au moins un des champs manquants est déclaré final | remet aussitôt votre texte déclaré en place | rien, toujours |
| les champs ont changé, mais le texte source est inchangé | réutilise le résultat enregistré — aucun appel à l'IA | rien |
| les champs ont changé et le texte source a réellement changé | il les régénère : il s'agit véritablement de nouvelle matière produit | un appel à l'IA facturé — dans la limite du plafond |
Il travaille par tranches, et cela compte. Chaque passage examine 500 résultats enregistrés et retient où il s'est arrêté, pour reprendre à partir de là une heure plus tard. La comparaison coûte deux requêtes par ligne : balayer un grand catalogue toutes les heures sans exception serait une charge que personne n'a demandée. Le catalogue entier est tout de même couvert — simplement étalé dans le temps. Sur un gros catalogue, cela signifie qu'un texte disparu peut attendre des heures, et sur un très gros catalogue quelques jours, avant que le contrôle ne l'atteigne. Il n'est pas bloqué : il n'y est pas encore arrivé. S'il vous faut une réponse tout de suite, bin/magento babel:reapply examine immédiatement ce que vous lui désignez.
Vous pilotez tout cela dans Stores → Configuration → Codingrow → AI Babel Enchanter → Keeping the texts in place :
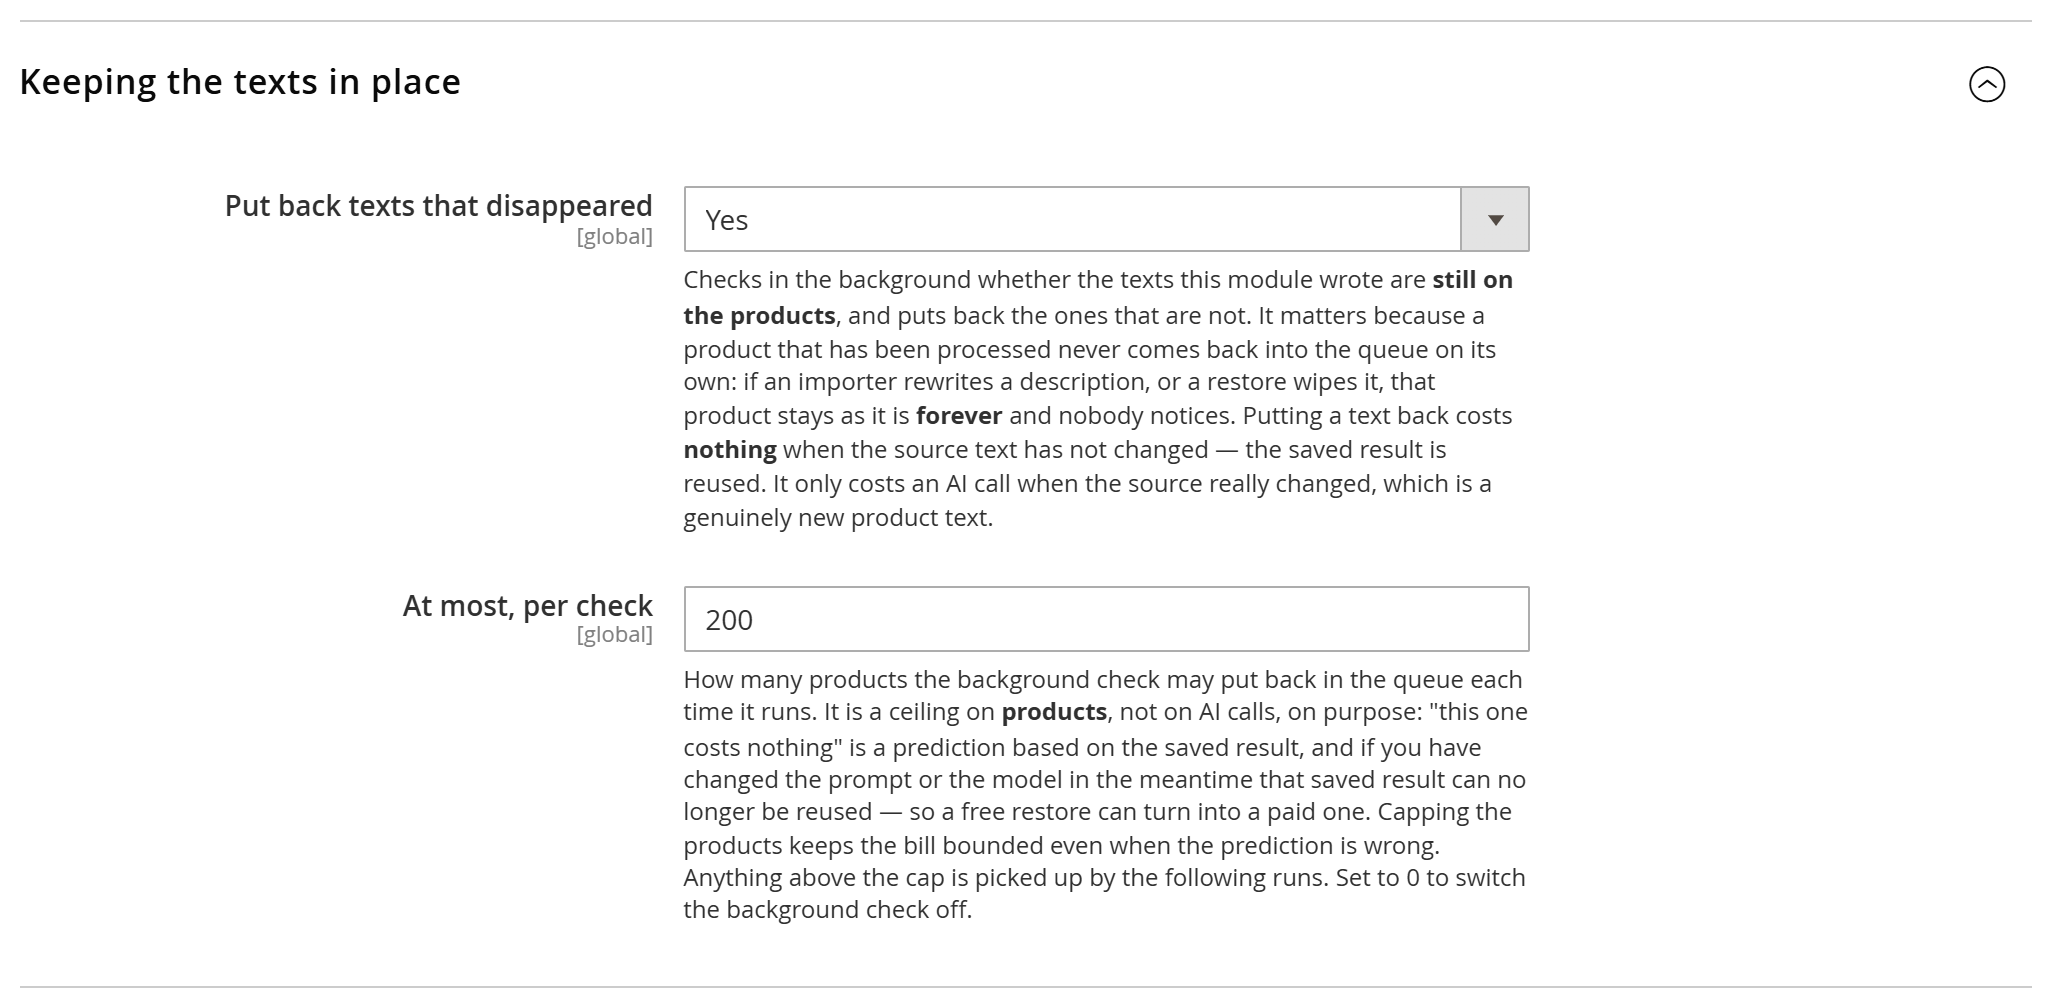
- Put back texts that disappeared — Yes par défaut. Réglez-le sur No et plus rien n'est jamais remis en place automatiquement ; il vous reste la commande
babel:reapplypour les passages manuels. - At most, per check — 200 par défaut. Ce qui dépasse le plafond est repris lors des passages suivants. Réglez-le sur 0 pour désactiver le contrôle en arrière-plan.
Pourquoi le plafond compte des produits et non des appels à l'IA. « Celui-ci ne coûte rien » est une prédiction fondée sur le résultat enregistré. Si vous avez changé le prompt ou le modèle entre-temps, ce résultat enregistré n'est plus réutilisable et une restauration qui semblait gratuite devient payante. Plafonner les produits garde la facture bornée même quand la prédiction est fausse. Les restaurations gratuites sont traitées en premier, de sorte que le travail bon marché est toujours fait avant que le plafond ne soit atteint.
Ce qu'il ne fait pas, et ce qu'il fait. Il ne touche jamais aux prix, aux stocks, aux images ni à aucun attribut en dehors de ceux que gère le profil, et il n'enrôle jamais un produit qui n'a jamais été traité. Mais soyons clairs sur la partie qui surprend : il remet le produit dans la file, et l'exécution réécrit alors tous les champs que ce profil gère. Donc si vous aviez corrigé l'un de ces champs sur la fiche produit, cette correction est remplacée. Ce n'est pas un bug, c'est la règle des deux canaux : une correction que vous voulez conserver a sa place dans la grille, ou reçoit la coche Final.
En ligne de commande, bin/magento babel:reapply se contente de faire un rapport et n'écrit rien tant que vous ne passez pas --confirm — la façon sûre de voir l'état d'un catalogue avant de décider. Ajoutez --only-free pour les seules restaurations gratuites, --profile et --limit pour restreindre le passage.
Appliquer un nouveau prompt aux produits déjà traités
Les profils sont délibérément conçus pour ne jamais revenir en arrière : un produit déjà traité n'est pas retraité, et c'est ce qui rend une nouvelle exécution du profil sûre et économique. Le revers de la médaille, c'est que lorsque vous améliorez le prompt de persona, l'amélioration n'atteint que les produits traités à partir de cet instant — tout ce qui est déjà fait conserve l'ancien texte. Jusqu'à la v3.4.0, le seul moyen de les inclure était babel:run --force en ligne de commande.
La page du profil dispose désormais d'un bouton pour cela.

Apply to already processed remet dans la file de ce profil les produits marqués done, partial et skipped. La confirmation énonce le coût en toutes lettres avant que quoi que ce soit ne se produise : « Les produits dont le texte source n'a pas changé sont réutilisés sans aucun coût. Les autres sont réécrits par l'IA, ce que votre fournisseur vous facture ; après un changement de persona ou d'instructions, attendez-vous donc à voir tout le profil réécrit. »
Cette dernière phrase n'est pas une formule de style. Chaque résultat magnifié est classé sous une clé qui inclut le fournisseur, le modèle et l'intégralité du prompt système. Changez la persona, changez le gabarit, changez le modèle, et plus aucun résultat magnifié du catalogue n'est réutilisable — et les traductions suivent, parce que ce qu'elles traduisent vient de changer. Appuyer sur ce bouton après un changement de prompt signifie donc « régénère tout ce profil, et paie pour cela ». Avant un changement de prompt, sur un catalogue intact, le même bouton est quasiment gratuit.
Utilisez-le quand vous avez amélioré le prompt et voulez mettre les anciens produits au nouveau standard ; quand vous avez ajouté un attribut à un groupe et voulez le voir rempli partout ; quand vous avez corrigé une erreur de mappage. Ne l'utilisez pas quand vous voulez seulement réparer des textes disparus — c'est le rôle du contrôle en arrière-plan décrit plus haut, et il coûte bien moins cher.
Les champs déclarés Final ne sont pas davantage régénérés par ce bouton.
Si votre catalogue est importé
Si les produits arrivent dans Magento depuis un flux fournisseur, un ERP, un PIM ou n'importe quel import planifié, cet importateur et Babel écrivent dans les mêmes champs. Que les deux cohabitent paisiblement dépend de la configuration de l'importateur et du nombre de vues magasin dont vous disposez — et quand ils ne cohabitent pas, le symptôme n'est pas un message d'erreur : c'est le texte que vous avez payé qui disparaît en silence pendant que tous les écrans continuent d'annoncer une réussite.
Le test d'acceptation prend une minute : enrichissez un produit, lancez l'import sans rien changer dans le flux, rechargez le produit. Si le texte de Babel est toujours là, cet importateur est compatible. Si le texte du fournisseur est revenu, il ne l'est pas — et aucun réglage de Babel n'y change quoi que ce soit.
Rollback
Chaque valeur écrite par le module est réversible. Au-delà du restaurer l'original par ligne dans la grille, la commande CLI babel:rollback réverte le contenu en masse — par profil, par produit ou pour toute l'exécution — vers le texte en place avant l'intervention du module. Comme l'original est toujours conservé, une exécution sur tout le catalogue n'est jamais une porte à sens unique.
Queue et circuit breaker sur les crédits
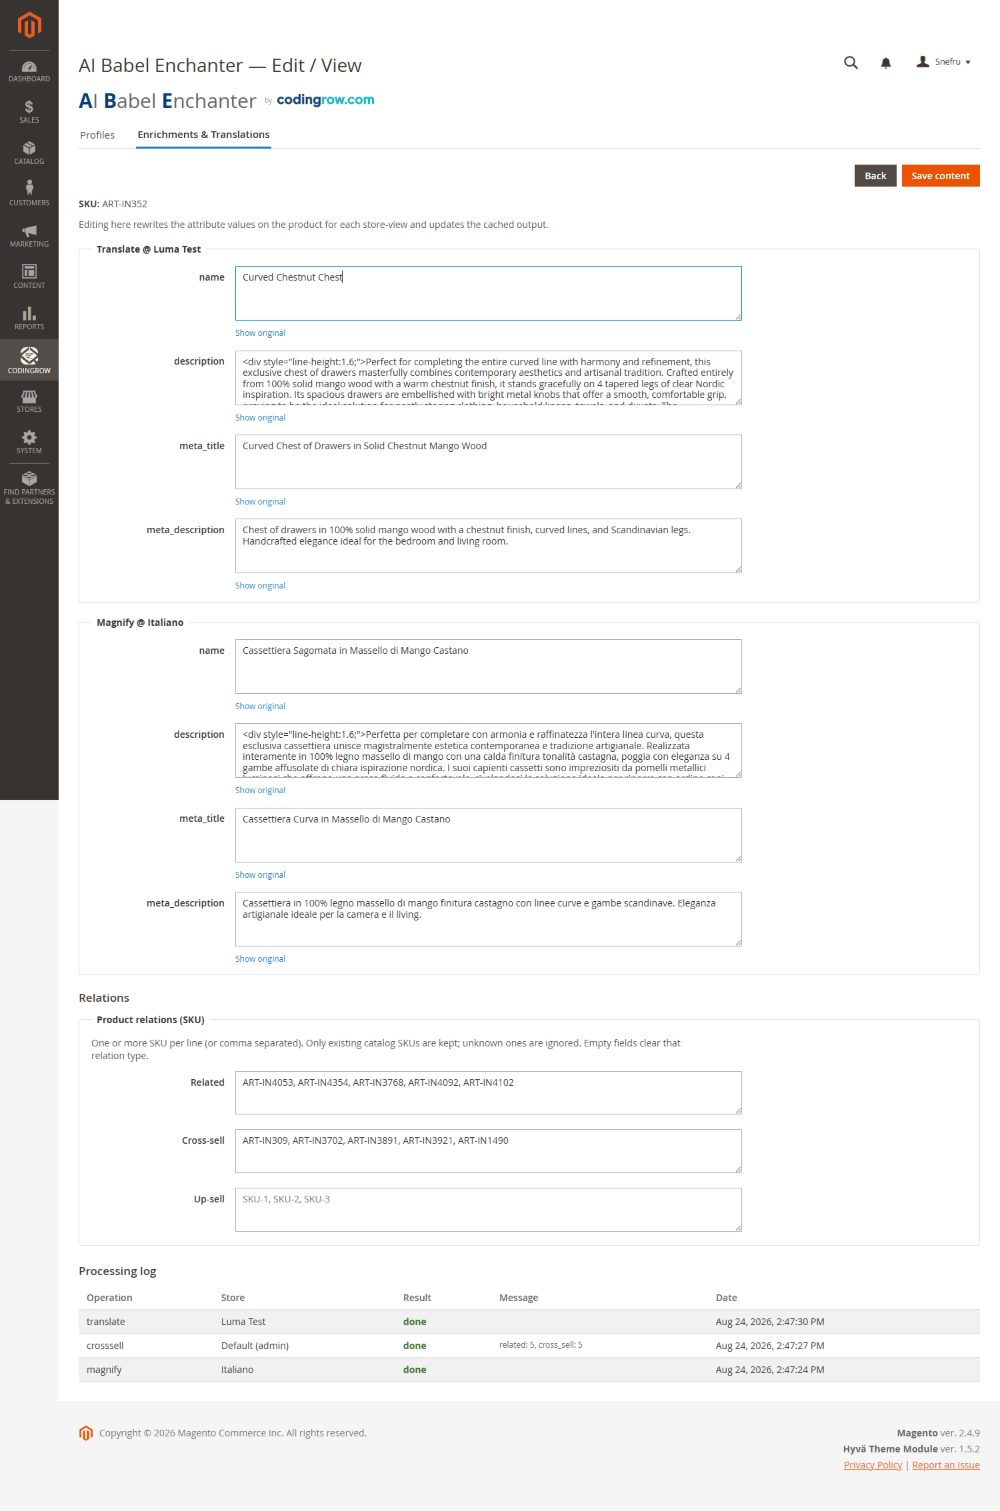
Les longues exécutions sont traitées via une file d'attente que vous pouvez observer, mettre en pause et reprendre. Le circuit breaker intégré (configuré dans Resilience) protège l'exécution : en cas d'erreurs répétées du fournisseur — le plus souvent le fournisseur sans crédit ou en rate limit — il se met en pause après N erreurs, attend le cooldown configuré et peut réessayer automatiquement les échecs transitoires au lieu de faire échouer tout le lot. Quand vous rechargez le crédit ou que la limite se réinitialise, reprenez la file d'attente et elle continue là où elle s'était arrêtée.
Fiches marchand : retours et livraison
Google lit sur la fiche produit les conditions de retour et de livraison pour les afficher dans ses fiches marchand gratuites, et la Search Console les signale comme manquantes quand elles ne sont pas là. Elles ne se déduisent pas du catalogue — ce sont des conditions commerciales — elles se déclarent donc dans la configuration, sous Merchant listings (returns and shipping). Les deux blocs sont désactivés par défaut et nécessitent les données structurées du produit.
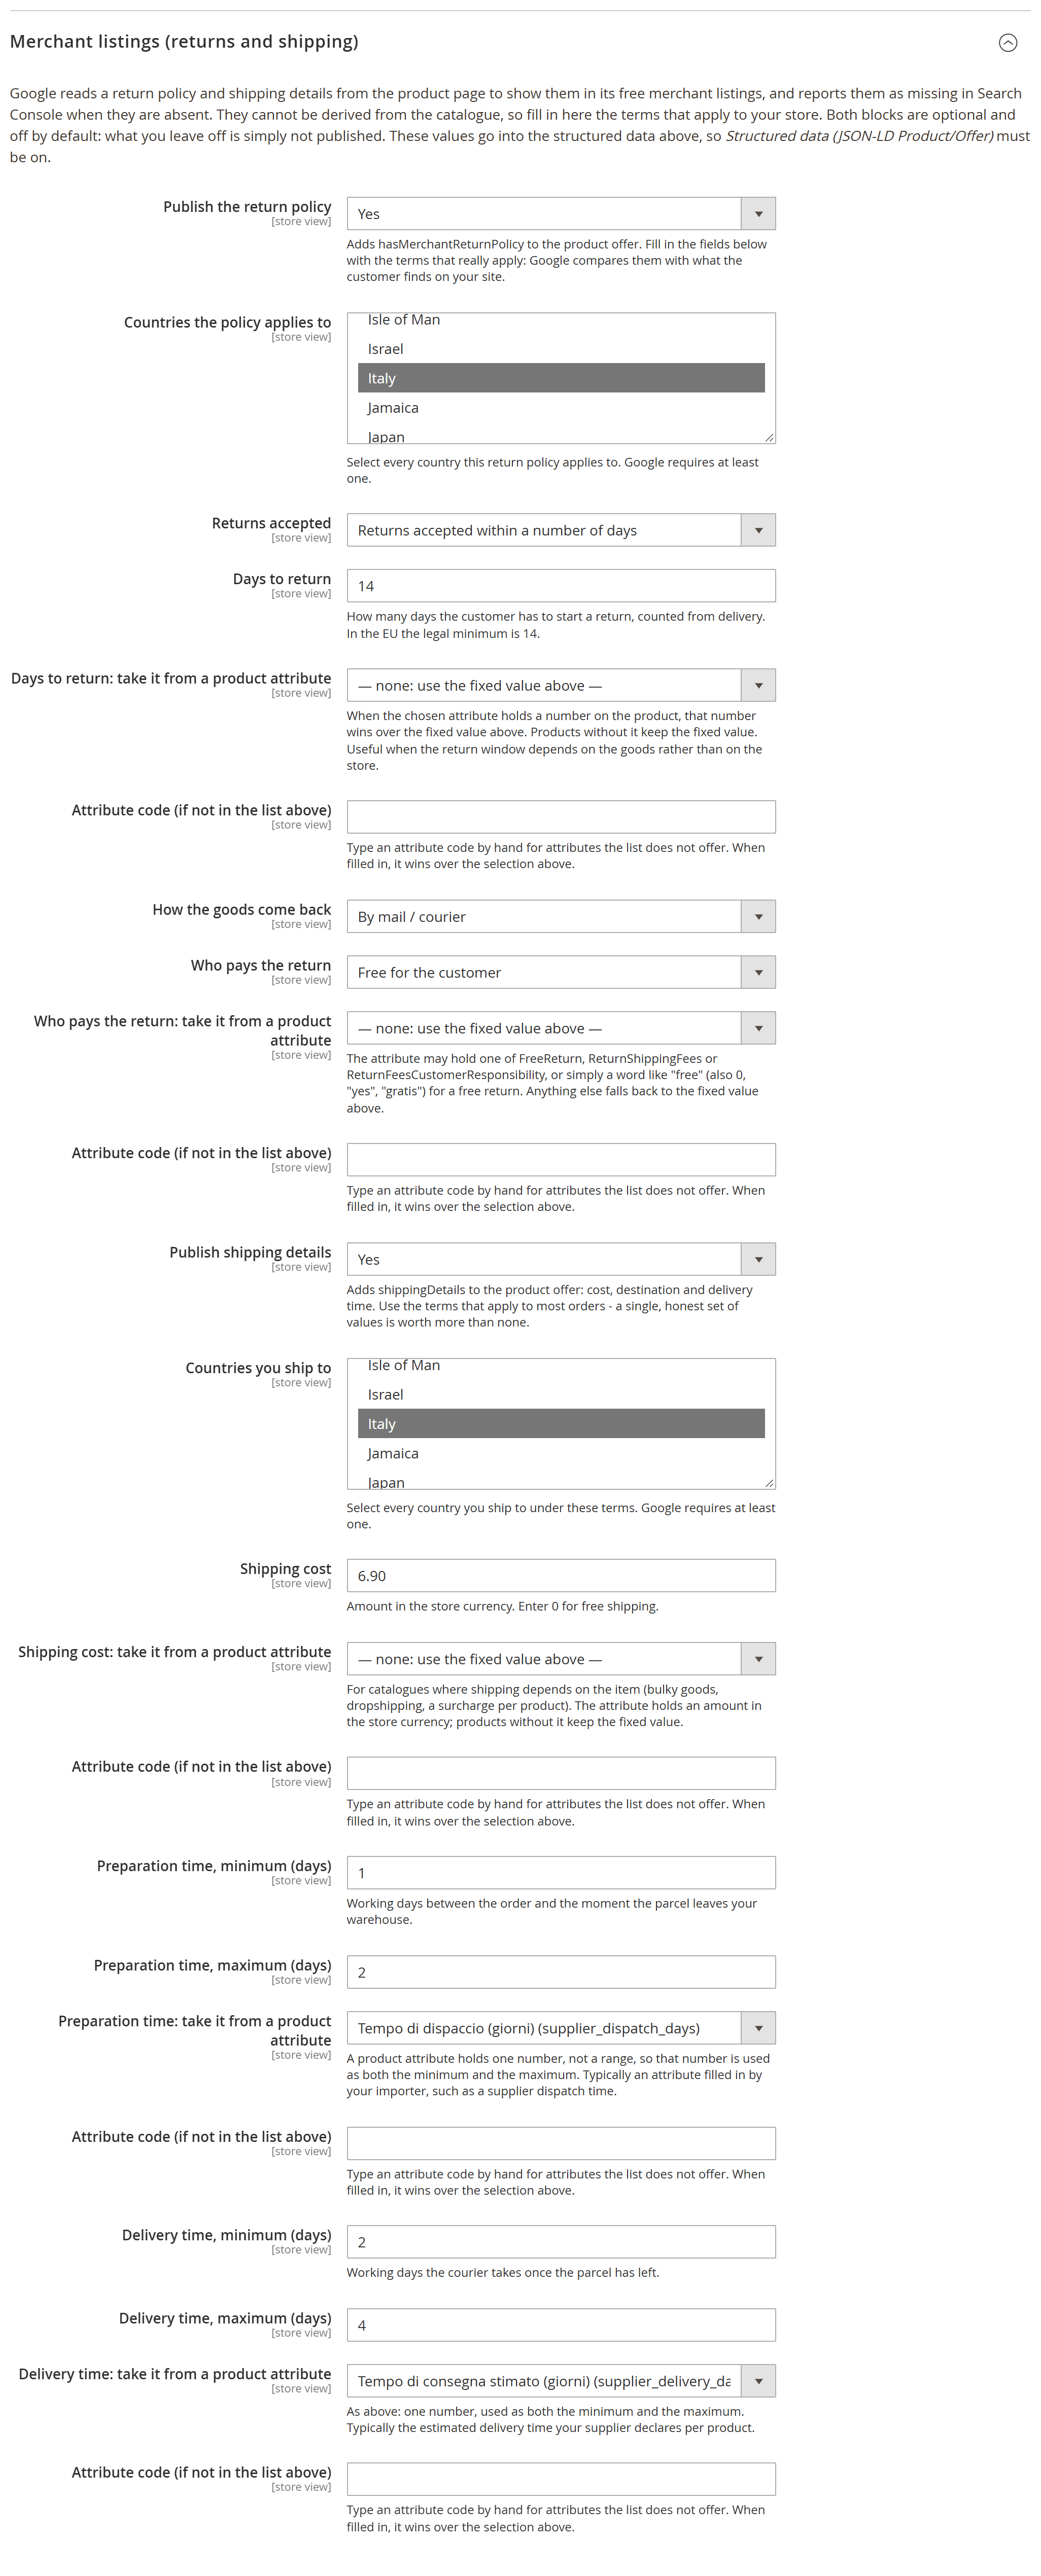
- Conditions de retour →
hasMerchantReturnPolicy: pays (choisis dans la liste de Magento), fenêtre de retour, nombre de jours, comment la marchandise revient, qui paie et les frais le cas échéant. - Conditions de livraison →
shippingDetails: pays livrés, frais (0pour la livraison gratuite), délais de préparation et de livraison en jours ouvrés.
Deux règles sont délibérées. Un bloc dont les champs obligatoires sont incomplets est écarté entièrement plutôt que publié à moitié : Google compare ce que vous déclarez avec ce que le client trouve sur votre site, une déclaration erronée vaut donc moins qu'une absente. Et avec « retours non acceptés », ni la méthode ni le payeur ne sont publiés : il n'y a pas de retour à décrire.
L'offre porte aussi validFrom, la date à partir de laquelle le prix publié s'applique : le début du prix spécial lorsqu'il y en a un, sinon la date de création du produit. Celle-ci ne demande aucune configuration.
Ces conditions valent rarement pour tout le catalogue : les délais de préparation et de livraison diffèrent entre entrepôt propre et dropshipping, la livraison dépend de l'encombrement, la fenêtre de retour de ce que l'on vend. Et le chiffre existe le plus souvent déjà sur le produit, dans un attribut que votre importateur ou votre équipe renseigne. Chacun de ces champs peut donc pointer vers un attribut produit — la liste comprend les vôtres — avec une case pour saisir un code que la liste ne propose pas. Là où le produit porte une valeur, c'est elle qui gagne ; sinon la valeur fixe demeure ; et une valeur qui n'est pas un nombre retombe sur la fixe au lieu de publier une absurdité.
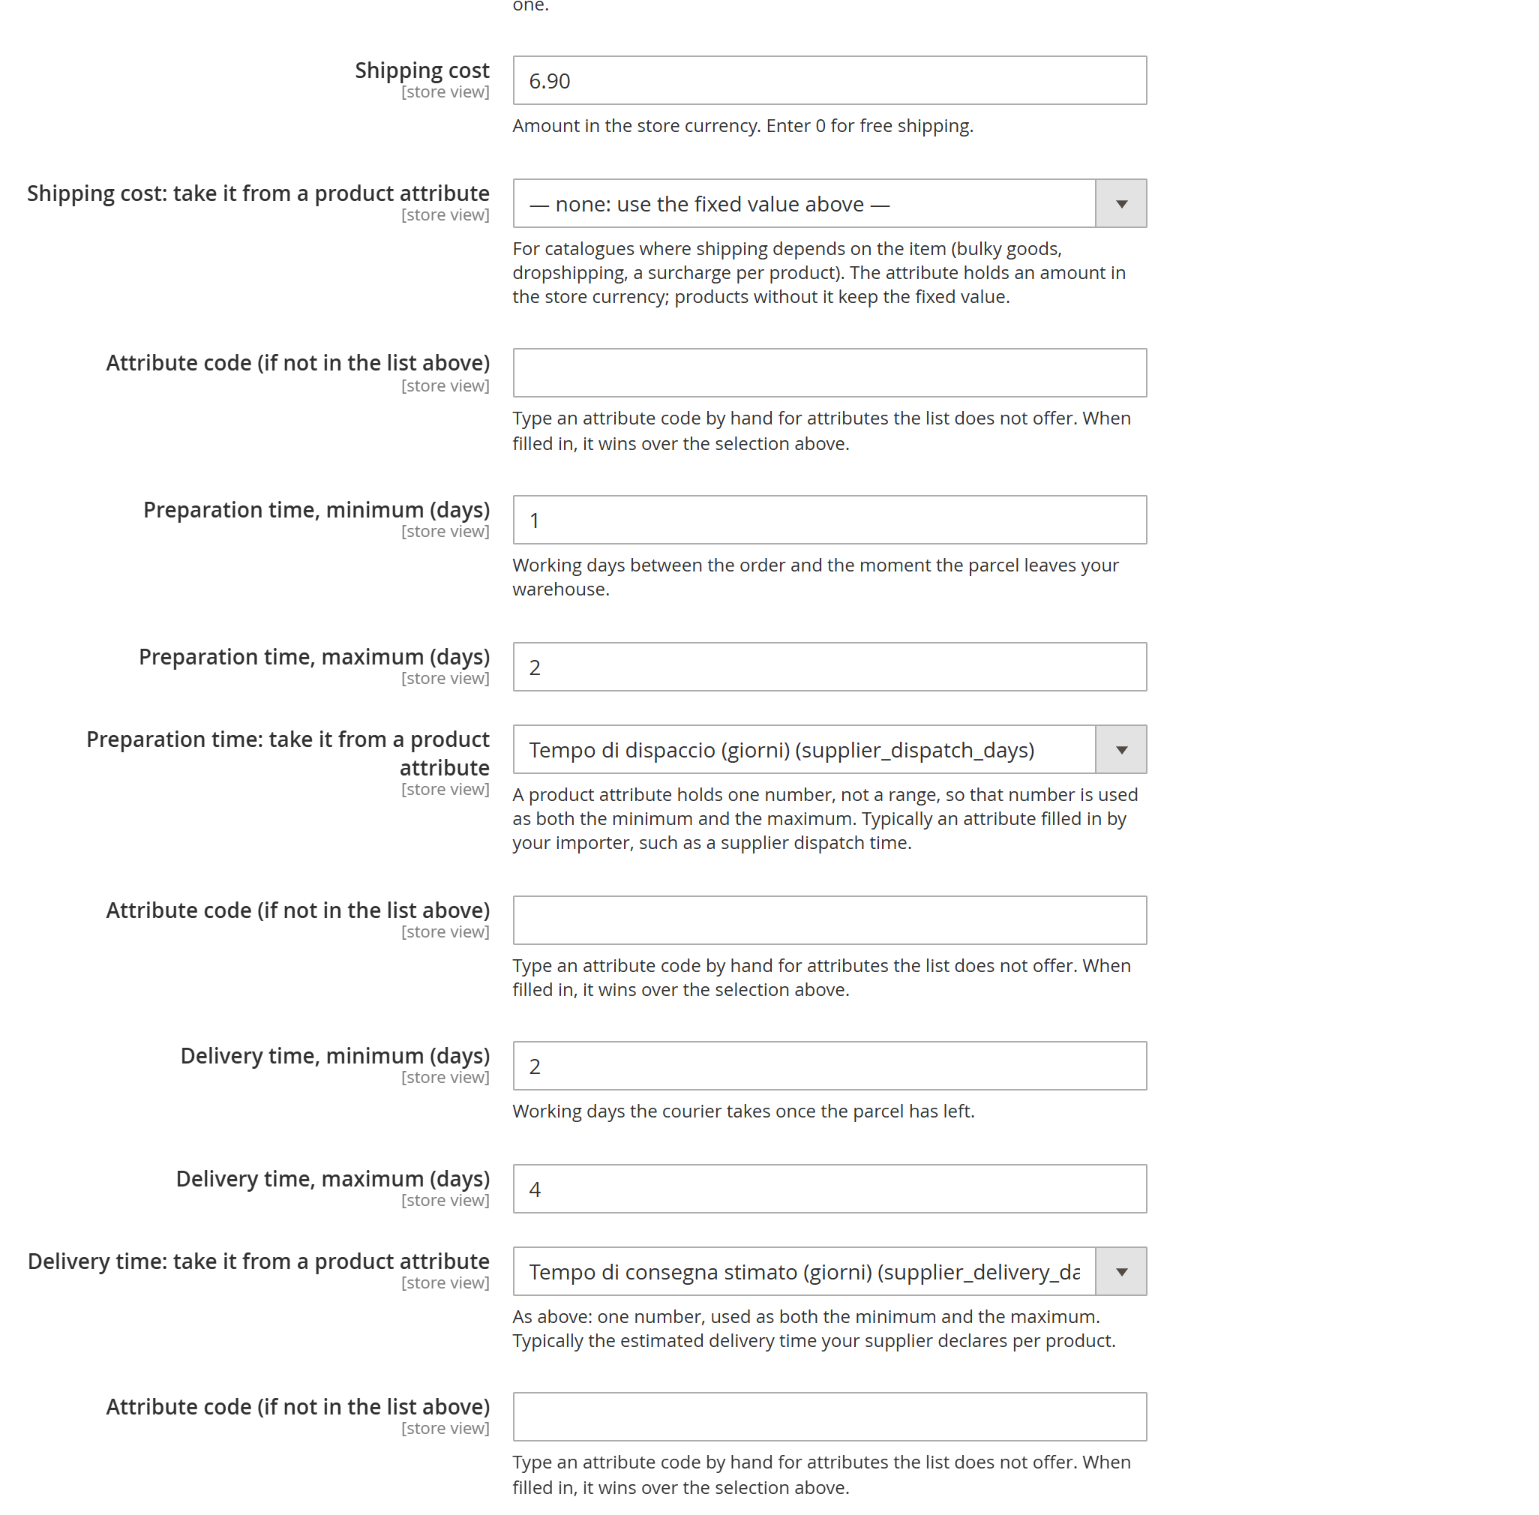
Chaque chiffre peut venir d'un attribut produit, choisi dans la liste du catalogue : ici les délais de préparation et de livraison proviennent des attributs renseignés par un importateur.
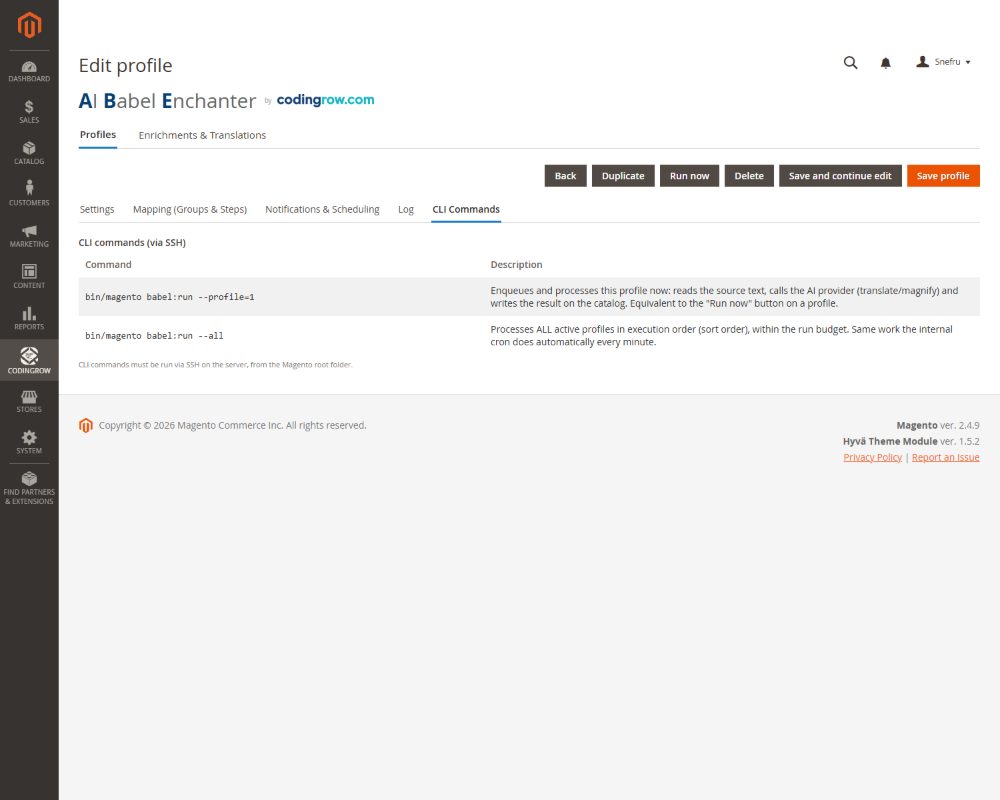
Ligne de commande (CLI)
Tout peut être piloté depuis la CLI pour la planification et les grandes exécutions.
| Commande | Ce que ça fait |
|---|---|
bin/magento babel:run | Exécute un profil (pipeline améliorer/traduire) sur ses produits cibles — la façon standard de lancer une passe sur tout le catalogue. |
bin/magento babel:rollback | Réverte le contenu généré vers le texte original, avec une portée par profil, produit ou toute l'exécution. |
bin/magento babel:queue | Inspecte et contrôle la file de traitement : statut, pause, reprise. |